 9146bfa03d
* refactor(gateway): issue request trace ids unconditionally

The request trace id was gated behind logging.enhance.enabled at every
entry point, so downstream code had to keep asking whether one existed:
a header-provenance flag in its own ContextVar, a precedence resolver,
and three-level carrier fallbacks at each consumer.

Bind one unconditionally instead. TraceMiddleware covers Gateway HTTP;
ensure_trace_context covers the entry points that never touch ASGI --
scheduled occurrences, MCP task notification runs, IM channel messages,
and the embedded client -- each scoped to one unit of work so a
long-lived worker task cannot leak one occurrence's id into the next.
The ContextVar becomes the only source; the response header, runtime
context, run metadata and log records are derived outputs.

Consumers now use ensure_trace_id() or resolve_trace_id(*carriers) and
drop their presence guards. Removed: resolve_deerflow_trace_id, the
header-provenance flag and its three helpers, set/reset_current_trace_id,
is_trace_correlation_enabled and its gateway alias.

BREAKING CHANGE: every Gateway HTTP response now carries X-Trace-Id and
it cannot be turned off; logging.enhance.enabled controls log output
only. Installations on the default enabled: false will start seeing the
header. No config keys were added or removed.

* fix(gateway): stop persisting a caller-supplied trace id on the run record

body.metadata forks two ways: through build_run_config into the live run
config, which the run worker restamps, and through create_or_reject into
the run record that the runs API echoes verbatim. Only the first was
covered, so a client sending metadata.deerflow_trace_id made the most
durable and most visible surface of a run disagree with the X-Trace-Id
and the log lines the same request produced -- a correlation id that
does not match the logs is worse than none.

Stamp the server-issued id once at the trust boundary so both forks
receive it, preserving the caller's own metadata keys. Close the same
gap on config.context, which reaches the runtime context by a separate
path: _build_runtime_context no longer merges server-owned keys from the
caller, and _install_runtime_context assigns rather than setdefaults.

A thread's metadata is no longer seeded with the run-scoped id of
whichever run created it -- one thread spans many runs and as many
trace ids.

Found by driving a real run through the Gateway and reading the run back
from the runs API; every unit test built its metadata by hand and so
could not see it.

* fix(gateway): expose X-Trace-Id to split-origin browser clients

X-Trace-Id is not on the CORS safelist, so a browser client served from
a separate origin could not read it -- and those are exactly the clients
that cannot read the Gateway's logs either, leaving them with nothing to
quote in a bug report. Same-origin nginx deployments were unaffected,
which is why this stayed hidden.

Add it to CORS_EXPOSED_HEADERS beside Content-Location, referencing
TRACE_ID_HEADER rather than repeating the literal.

* fix(gateway): keep X-Trace-Id on unhandled-exception 500s

Starlette's ServerErrorMiddleware sits outside every user middleware and
emits unhandled-exception 500s through the raw send, so those responses
never pass TraceMiddleware's header-writing wrapper. The 500 for a server
bug is exactly the response a user most needs to correlate with a log line,
and it was the one response that shipped without the id.

TraceMiddleware now tracks whether http.response.start has been sent. On an
exception with no response started it emits its own plain 500 carrying the
header, then re-raises: the outer ServerErrorMiddleware sees the response
already started and only re-raises too, so the server's exception logging is
untouched. An exception mid-stream keeps propagating unchanged — a second
response start cannot be sent, and the already-written header stands.

The trace id is printable ASCII by construction (normalize_trace_id /
generate_trace_id), which is what makes the raw latin-1 header encoding
safe.

* fix(gateway): strip the forged trace id from the persisted request echo

The run-record fix stopped a forged metadata.deerflow_trace_id on the
authoritative metadata surface, but the raw request echo still carried one:
create_or_reject persists body.config verbatim as runs.kwargs_json, which
the runs API serves back. A client posting config.context.deerflow_trace_id
therefore still got its forged value stored and echoed on one API surface
while the header, logs, run metadata, and checkpoint all carried the real
id — the id is ignored as input there, so echoing it back only manufactures
disagreement.

Two changes close it. redact_config_secrets — already the shared scrub for
that echo, applied at admission and again at serve time, so historical
records are covered too — now also drops deerflow_trace_id from
config.metadata and config.context. And build_run_config now merges run
metadata onto a copy of the caller's config["metadata"] instead of updating
it in place: the nested values of the request config are reference copies,
so the in-place merge was writing the server-stamped key through into
body.config, contaminating the "what the client sent" record before it was
persisted (and incidentally masking the forged-value echo on the metadata
container).

The regression test posts a forged id through body.metadata,
config.metadata, and config.context at once and reads the kwargs echo back
off the run record, failing if either leak returns.

* docs(harness): record the trace-echo scrub, 500 fallback, and accepted retry divergence

The trace section of the harness AGENTS.md now covers the two fixes that
close the derived-output rule (the kwargs-echo scrub in
redact_config_secrets plus build_run_config's copy merge, and
TraceMiddleware's own 500 for unhandled exceptions), and CHANGELOG gains
their Fixed entries.

It also writes down the one accepted divergence: a crash-recovered
scheduled launch reuses the durable run through its idempotency key, and
start_run returns early on idempotency_reused without restamping — so the
run record keeps the first attempt's deerflow_trace_id while the retry's
own log lines carry the freshly minted id of its ensure_trace_context
binding. The divergence is confined to the crash-recovery window and is
accepted rather than fixed: restamping on reuse would rewrite a persisted
record for a run that already exists, which is worse than two ids that each
correlate their own attempt's logs. Written down so the next reader of the
scheduler recovery path does not diagnose it as a bug.

* docs(config): align the logging.enhance schema note with the unconditional trace id

The config-module AGENTS.md still described logging.enhance as the gate for
the Gateway X-Trace-Id header and Langfuse deerflow_trace_id. That model is
gone: ids are issued unconditionally and this block decides log output only.
Left as-is, the stale wording invites an agent to "restore" a header gate it
believes was lost. Reworded to match the sibling AGENTS.md files and
config.example.yaml, with a pointer to the Request Trace Context section
that owns the full model.

* docs(changelog): link the trace entries to #5119

The five new entries pointed at the ([#XXXX]) placeholder with no reference
definition, rendering as literal text instead of a link — and RELEASING.md
step 2 relies on those references when the section becomes release notes.
All five now point at #5119, with the definition appended to the reference
block.

* refactor(harness): rename _stream_without_trace_context to _stream_turn

The name asserted the opposite of what the method now does. It was accurate
while logging.enhance.enabled could route stream() around the trace scope;
with the gate gone it is the only stream implementation left, and it binds
the id itself via ensure_trace_id(). Private, so the rename touches only the
definition and the one stream() call site.

* docs(harness): fit the trace-context guidance inside the AGENTS.md chain budget

The expanded Request Trace Context section pushed the effective AGENTS.md
chain for agents/middlewares to 99,815 bytes, past the 98,304 hard limit
scripts/check_agent_guidance.py enforces in CI (AG002). Compressed the
section from 7,359 to 4592 bytes with no facts removed: the entry-point
table, the derived-output rule and its enforcement points, the accepted
scheduled-retry divergence, the two resolution helpers, the stream()
binding rationale, the log-output-only gate, the CORS listing, the 500
fallback, and the test map all remain.

Sized against the merge, not just the branch: current main grew the same
chain by ~724 bytes, so the check was verified on the merged tree as well
(97,772 bytes; branch tree 97,048).

* fix(gateway): declare content-length on the fallback 500

The pre-response 500 declared content-type but no content-length, leaving
the framing to the ASGI server: chunked on HTTP/1.1, close-delimited on
HTTP/1.0 — the one wire difference from the ServerErrorMiddleware response
it replaces, which sends content-length: 21. The explicit header keeps the
fallback byte-identical to what clients saw before.

* docs(readme): drop the trace-correlation condition from the translations

The zh/ja/fr/ru Langfuse sections still said metadata.deerflow_trace_id
matches X-Trace-Id "when request trace correlation is enabled". The id now
always matches and that condition no longer exists, so each bullet states
the unconditional match and that logging.enhance.enabled only controls
whether the id is printed into logs — the one piece of the feature a user
can still configure.

* test(gateway): pin TraceMiddleware wiring through create_app()

Every X-Trace-Id test exercised a hand-built four-route app, so the real
stack's add_middleware(TraceMiddleware) line was pinned by nothing: deleting
it — or short-circuiting above it — passed CI while silently dropping both
the response header and the ambient id the run-record stamp and enhanced log
records derive from. One case now drives /health through create_app() and
asserts the inbound id round-trips; mutation-checked by removing the wiring
line, which fails exactly this test.

* docs(gateway): note the fallback 500 is CORS-opaque

The pre-response 500 is emitted outside CORSMiddleware — the exception has
already unwound past it — so it carries no Access-Control-Allow-Origin and
a split-origin browser client cannot read the id on this one response,
unchanged from the ServerErrorMiddleware 500 it replaces. Documented on the
class and in the CHANGELOG entry rather than fixed: replicating the origin
allowlist outside CORSMiddleware would let the two policies drift.

* fix(harness): keep abandoned-stream cleanup inside the trace binding

stream() binds the turn's id around each next(inner) and resets it before
yielding, but the finally's inner.close() ran after that binding was gone.
Abandoning the stream therefore drove the inner LangGraph generator's
GeneratorExit/finally path with no trace id — or an unrelated ambient one
from whichever context ran the close — so cancellation and finalization
logs and callbacks did not correlate with the turn they belong to.

inner.close() is now wrapped in a local bind/reset of the same turn id. The
token is set and reset in the same frame, never across a yield, so the
per-step cross-context safety is preserved even when GC closes the
generator from another Context — pinned by the existing copy_context close
test, which now exercises this path. The regression test records the id
from the inner generator's finally and fails without the binding.

* test(harness): teach the worker-trace fake about RunManager.cleanup

Upstream #5112 (bound gateway memory after terminal runs) added a
run_manager.cleanup(run_id) call to run_agent's finalization, so the
merge-commit CI run failed all five worker-trace-binding tests with
AttributeError on this PR's _FakeRunManager. The fake gains the same no-op
shape as its other methods.

* docs(gateway): bring the gateway AGENTS.md back under its soft budget

Upstream #5092 grew backend/app/gateway/AGENTS.md to 40,966 bytes, 6 over
the 40,960 soft budget that
test_agent_guidance_check.py::test_repository_guidance_stays_below_soft_budgets_and_avoids_doc_indexes
enforces — its Unit Tests run on main was cancelled by push concurrency, so
main is currently red on that test and every PR merge-run inherits the
failure. Two whitespace/wording trims in the row #5092 touched (a doubled
space, and "its configured `context_window`" → "its `context_window`")
bring the file to 40,953 with no content change.

---------

Co-authored-by: Willem Jiang <willem.jiang@gmail.com>
51 KiB
🦌 DeerFlow - 2.0
English | 中文 | 日本語 | Français | Русский

28 февраля 2026 года DeerFlow занял 🏆 #1 в GitHub Trending после релиза версии 2. Спасибо огромное нашему сообществу — всё благодаря вам! 💪🔥
DeerFlow (Deep Exploration and Efficient Research Flow) — open-source Super Agent Harness, который управляет Sub-Agents, Memory и Sandbox для решения почти любой задачи. Всё на основе расширяемых Skills.
https://github.com/user-attachments/assets/a8bcadc4-e040-4cf2-8fda-dd768b999c18
Note
DeerFlow 2.0 — проект переписан с нуля. Общего кода с v1 нет. Если нужен оригинальный Deep Research фреймворк — он живёт в ветке
1.x, туда тоже принимают контрибьюты. Активная разработка идёт в 2.0.
Официальный сайт
Больше информации и живые демо на официальном сайте.
Родственные проекты
- LLM Space - Познакомьтесь с нашим секретным оружием за DeerFlow — настольный инструмент для прототипирования идей агентов, проверки каждого шага харнесса, воспроизведения сбоев и тестирования производительности.
Coding Plan от ByteDance Volcengine
- Рекомендуем Doubao-Seed-2.0-Code, DeepSeek v3.2 и Kimi 2.5 для запуска DeerFlow
- Подробнее
- Для разработчиков из материкового Китая
InfoQuest
DeerFlow интегрирован с инструментарием для умного поиска и краулинга от BytePlus — InfoQuest (есть бесплатный онлайн-доступ)
Содержание
- 🦌 DeerFlow - 2.0
- Официальный сайт
- Coding Plan от ByteDance Volcengine
- InfoQuest
- Содержание
- Установка одной фразой для coding agent
- Быстрый старт
- От Deep Research к Super Agent Harness
- Core Features
- Рекомендуемые модели
- Встроенный Python-клиент
- Запланированные задачи (Scheduled Tasks)
- Терминальная панель (TUI)
- Документация
- ⚠️ Безопасность
- Участие в разработке
- Лицензия
- Благодарности
- История звёзд
Установка одной фразой для coding agent
Если вы используете Claude Code, Codex, Cursor, Windsurf или другой coding agent, просто отправьте ему эту фразу:
Если DeerFlow еще не клонирован, сначала клонируй его, а затем подготовь локальное окружение разработки по инструкции https://raw.githubusercontent.com/bytedance/deer-flow/main/Install.md
Этот prompt предназначен для coding agent. Он просит агента при необходимости сначала клонировать репозиторий, предпочесть Docker, если он доступен, и в конце вернуть точную команду запуска и список недостающих настроек.
Быстрый старт
Конфигурация
-
Склонировать репозиторий DeerFlow
git clone https://github.com/bytedance/deer-flow.git cd deer-flow -
Запустить мастер настройки (рекомендуется)
Из корня проекта (
deer-flow/) запустите:make setupЗапустится интерактивный мастер, который поможет выбрать LLM-провайдера, опциональный веб-поиск и настройки выполнения/безопасности (режим sandbox, доступ к bash, инструменты записи файлов). Он сгенерирует минимальный
config.yamlи запишет ключи в.env. Это занимает около 2 минут.В любой момент запускайте
make doctor, чтобы проверить конфигурацию и получить конкретные подсказки по исправлению. Если вы открываете GitHub issue о проблеме с локальной установкой или работой системы, выполнитеmake support-bundle. Команда выводит дальнейшие шаги для автора отчёта, создаёт файл*-issue-summary.md, который нужно вставить в issue, файл*-issue-draft.mdдля оформления issue с помощью AI и, опционально, zip-архив с диагностикой в.deer-flow/support-bundles/. Если issue оформляет AI-ассистент, он должен начать с черновика и заменить каждый плейсхолдер REQUIRED, а не выдумывать недостающие факты. Прикладывайте zip-архив только если его запросит мейнтейнер или если одной сводки недостаточно. Мейнтейнеры и AI-инструменты триажа могут начинать сtriage.json; архив содержит только очищенную от чувствительных данных диагностику и манифесты файлов и не включает.env, исходные сообщения диалогов или содержимое пользовательских файлов.Продвинутая / ручная настройка: если вы предпочитаете редактировать
config.yamlнапрямую, выполните вместо этогоmake config, чтобы скопировать полный шаблон. Полный справочник —config.example.yaml, включая CLI-провайдеров (Codex CLI, Claude Code OAuth), OpenRouter, Responses API и многое другое.Примеры ручной настройки моделей
models:
  - name: gpt-4o
    display_name: GPT-4o
    use: langchain_openai:ChatOpenAI
    model: gpt-4o
    api_key: $OPENAI_API_KEY

  - name: openrouter-gemini-2.5-flash
    display_name: Gemini 2.5 Flash (OpenRouter)
    use: langchain_openai:ChatOpenAI
    model: google/gemini-2.5-flash-preview
    api_key: $OPENROUTER_API_KEY
    base_url: https://openrouter.ai/api/v1

  - name: gpt-5-responses
    display_name: GPT-5 (Responses API)
    use: langchain_openai:ChatOpenAI
    model: gpt-5
    api_key: $OPENAI_API_KEY
    use_responses_api: true
    output_version: responses/v1

  - name: qwen3-32b-vllm
    display_name: Qwen3 32B (vLLM)
    use: deerflow.models.vllm_provider:VllmChatModel
    model: Qwen/Qwen3-32B
    api_key: $VLLM_API_KEY
    base_url: http://localhost:8000/v1
    supports_thinking: true
    when_thinking_enabled:
      extra_body:
        chat_template_kwargs:
          enable_thinking: true
OpenRouter и аналогичные OpenAI-совместимые шлюзы настраиваются через
langchain_openai:ChatOpenAIс параметромbase_url. Если вы предпочитаете имя переменной окружения, специфичное для провайдера, укажите его вapi_keyявно (например,api_key: $OPENROUTER_API_KEY).Чтобы направить модели OpenAI через
/v1/responses, продолжайте использоватьlangchain_openai:ChatOpenAIи задайтеuse_responses_api: trueвместе сoutput_version: responses/v1.Для vLLM 0.19.0 используйте
deerflow.models.vllm_provider:VllmChatModel. Для reasoning-моделей в стиле Qwen DeerFlow переключает режим рассуждений черезextra_body.chat_template_kwargs.enable_thinkingи сохраняет нестандартное полеreasoningvLLM в многоходовых диалогах с вызовами инструментов. Устаревшие конфигурацииthinkingавтоматически нормализуются для обратной совместимости. Reasoning-моделям также может потребоваться запуск сервера с флагом--reasoning-parser .... Если ваш локальный vLLM принимает любой непустой API-ключ, всё равно задайтеVLLM_API_KEYсо значением-заглушкой.Примеры CLI-провайдеров:
models: - name: gpt-5.4 display_name: GPT-5.4 (Codex CLI) use: deerflow.models.openai_codex_provider:CodexChatModel model: gpt-5.4 supports_thinking: true supports_reasoning_effort: true - name: claude-sonnet-4.6 display_name: Claude Sonnet 4.6 (Claude Code OAuth) use: deerflow.models.claude_provider:ClaudeChatModel model: claude-sonnet-4-6 max_tokens: 4096 supports_thinking: true- Codex CLI читает
~/.codex/auth.json - Claude Code принимает
CLAUDE_CODE_OAUTH_TOKEN,ANTHROPIC_AUTH_TOKEN,CLAUDE_CODE_CREDENTIALS_PATHили~/.claude/.credentials.json - Записи ACP-агентов настраиваются отдельно от провайдеров моделей — если вы настраиваете
acp_agents.codex, укажите в нём Codex ACP-адаптер, напримерnpx -y @zed-industries/codex-acp - На macOS при необходимости экспортируйте аутентификацию Claude Code явно:
eval "$(python3 scripts/export_claude_code_oauth.py --print-export)"API-ключи также можно задать вручную в
.env(рекомендуется) или экспортировать в оболочке:OPENAI_API_KEY=your-openai-api-key TAVILY_API_KEY=your-tavily-api-key - Codex CLI читает
Запуск
Вариант 1: Docker (рекомендуется)
Разработка (hot-reload, монтирование исходников):
make docker-init    # Загрузить образ Sandbox (один раз или при обновлении)
make docker-start   # Запустить сервисы
Продакшен (собирает образы локально):
make up     # Собрать образы и запустить все сервисы
make down   # Остановить и удалить контейнеры
Tip
На Linux при ошибке
permission deniedдля Docker daemon добавьте пользователя в группуdockerи перелогиньтесь. Подробнее в CONTRIBUTING.md.
Адрес: http://localhost:2026
Вариант 2: Локальная разработка
Предварительное условие: сначала выполните шаги раздела «Конфигурация» выше (make setup). Для make dev нужен корректный config.yaml в корне проекта. Задайте DEER_FLOW_PROJECT_ROOT, чтобы явно указать корень проекта, или DEER_FLOW_CONFIG_PATH, чтобы указать конкретный файл конфигурации. Состояние времени выполнения по умолчанию записывается в .deer-flow в корне проекта и может быть перенесено через DEER_FLOW_HOME; skills по умолчанию читаются из skills/ в корне проекта, путь можно переопределить через DEER_FLOW_SKILLS_PATH. Перед запуском выполните make doctor, чтобы проверить настройку.
В Windows запускайте локальный процесс разработки из Git Bash. Нативные оболочки cmd.exe и PowerShell не поддерживаются для сервисных скриптов на bash, а работа в WSL не гарантируется, поскольку некоторые скрипты зависят от утилит Git for Windows, таких как cygpath.
-
Проверить зависимости:
make check # Проверяет Node.js 22+, pnpm, uv, nginx -
Установить зависимости:
make install -
(Опционально) Загрузить образ Sandbox заранее:
make setup-sandbox -
Запустить сервисы:
make dev -
Адрес: http://localhost:2026
Дополнительно
Режим Sandbox
DeerFlow поддерживает несколько режимов выполнения:
- Локальное выполнение — код запускается прямо на хосте
- Docker — код выполняется в изолированных Docker-контейнерах
- Docker + Kubernetes — выполнение в Kubernetes-подах через provisioner
Подробнее в руководстве по конфигурации Sandbox.
MCP-сервер
DeerFlow поддерживает настраиваемые MCP-серверы для расширения возможностей. Для HTTP/SSE MCP-серверов поддерживаются OAuth-токены (client_credentials, refresh_token). Подробнее в руководстве по MCP-серверу.
Мессенджеры
DeerFlow принимает задачи прямо из мессенджеров. Каналы запускаются автоматически при настройке, публичный IP не нужен.
DeerFlow может также предоставлять в workspace UI пользовательские подключения IM-каналов. Когда включён channel_connections, вошедшие в систему пользователи могут привязать Telegram, Slack, Discord, Feishu/Lark, DingTalk, WeChat или WeCom из боковой панели / Settings > Channels. Это переиспользует существующие исходящие транспорты channels.*, поэтому публичный IP или URL обратного вызова провайдера не требуются. Входящие IM-сообщения выполняются от имени подключённого пользователя DeerFlow. Настройки и вопросы безопасности описаны в IM Channel Connections.
| Канал | Транспорт | Сложность |
|---|---|---|
| Telegram | Bot API (long-polling) | Просто |
| Slack | Socket Mode | Средне |
| Feishu / Lark | WebSocket | Средне |
| Tencent iLink (long-polling) | Средне | |
| WeCom | WebSocket | Средне |
| DingTalk | Stream Push (WebSocket) | Средне |
Конфигурация в config.yaml:
channels:
  feishu:
    enabled: true
    app_id: $FEISHU_APP_ID
    app_secret: $FEISHU_APP_SECRET
    # domain: https://open.feishu.cn       # China (default)
    # domain: https://open.larksuite.com   # International

  wecom:
    enabled: true
    bot_id: $WECOM_BOT_ID
    bot_secret: $WECOM_BOT_SECRET

  slack:
    enabled: true
    bot_token: $SLACK_BOT_TOKEN
    app_token: $SLACK_APP_TOKEN
    allowed_users: []

  telegram:
    enabled: true
    bot_token: $TELEGRAM_BOT_TOKEN
    allowed_users: []

  wechat:
    enabled: false
    bot_token: $WECHAT_BOT_TOKEN
    ilink_bot_id: $WECHAT_ILINK_BOT_ID
    qrcode_login_enabled: true      # опционально: разрешить первичную загрузку через QR-код при отсутствии bot_token
    allowed_users: []               # пусто = разрешить всем
    polling_timeout: 35
    state_dir: ./.deer-flow/wechat/state
    max_inbound_image_bytes: 20971520
    max_outbound_image_bytes: 20971520
    max_inbound_file_bytes: 52428800
    max_outbound_file_bytes: 52428800

  dingtalk:
    enabled: true
    client_id: $DINGTALK_CLIENT_ID             # ClientId с DingTalk Open Platform
    client_secret: $DINGTALK_CLIENT_SECRET     # ClientSecret с DingTalk Open Platform
    allowed_users: []                          # пусто = разрешить всем
    card_template_id: ""                       # Опционально: ID шаблона AI Card для потокового эффекта печатной машинки
Ключи API в .env:
# Telegram
TELEGRAM_BOT_TOKEN=123456789:ABCdefGHIjklMNOpqrSTUvwxYZ

# Slack
SLACK_BOT_TOKEN=xoxb-...
SLACK_APP_TOKEN=xapp-...

# Feishu / Lark
FEISHU_APP_ID=cli_xxxx
FEISHU_APP_SECRET=your_app_secret

# WeChat iLink
WECHAT_BOT_TOKEN=your_ilink_bot_token
WECHAT_ILINK_BOT_ID=your_ilink_bot_id

# WeCom
WECOM_BOT_ID=your_bot_id
WECOM_BOT_SECRET=your_bot_secret

# DingTalk
DINGTALK_CLIENT_ID=your_client_id
DINGTALK_CLIENT_SECRET=your_client_secret
Настройка Telegram
- Напишите @BotFather, отправьте
/newbotи скопируйте HTTP API-токен. - Укажите
TELEGRAM_BOT_TOKENв.envи включите канал вconfig.yaml.
Настройка WeChat
- Включите канал
wechatвconfig.yaml. - Либо задайте
WECHAT_BOT_TOKENв.env, либо установитеqrcode_login_enabled: trueдля первичной загрузки через QR-код. - Когда
bot_tokenотсутствует и загрузка через QR включена, следите за логами бэкенда — там появится QR-контент, возвращённый iLink, — и завершите процесс привязки. - После успешного прохождения QR-процесса DeerFlow сохраняет полученный токен в
state_dirдля последующих перезапусков. - Для развёртываний Docker Compose держите
state_dirна постоянном томе, чтобы курсорget_updates_bufи сохранённое состояние аутентификации переживали перезапуски.
Настройка WeCom
- Создайте бота на платформе WeCom AI Bot и получите
bot_idиbot_secret. - Включите
channels.wecomвconfig.yamlи заполнитеbot_id/bot_secret. - Задайте
WECOM_BOT_IDиWECOM_BOT_SECRETв.env. - Убедитесь, что зависимости бэкенда включают
wecom-aibot-python-sdk. Канал использует долговременное WebSocket-соединение и не требует публичного URL обратного вызова. - Текущая интеграция поддерживает входящие текстовые сообщения, изображения и файлы. Итоговые изображения/файлы, сгенерированные агентом, также отправляются обратно в диалог WeCom.
Настройка DingTalk
- Создайте приложение на DingTalk Open Platform и включите возможность Робот.
- На странице настроек робота установите режим приёма сообщений на Stream.
- Скопируйте
Client IDиClient Secret. УкажитеDINGTALK_CLIENT_IDиDINGTALK_CLIENT_SECRETв.envи включите канал вconfig.yaml. - (Опционально) Для включения потоковых ответов AI Card (эффект печатной машинки) создайте шаблон AI Card на платформе карточек DingTalk, затем укажите
card_template_idвconfig.yamlс ID шаблона. Также необходимо запросить разрешенияCard.Streaming.WriteиCard.Instance.Write.
Доступные команды
| Команда | Описание |
|---|---|
/new |
Начать новый диалог |
/status |
Показать информацию о текущем треде |
/models |
Список доступных моделей |
/memory |
Просмотреть память |
/help |
Показать справку |
Сообщения без команды воспринимаются как обычный чат — DeerFlow создаёт тред и отвечает.
Трассировка LangSmith
DeerFlow имеет встроенную интеграцию с LangSmith для наблюдаемости. При включении все вызовы LLM, запуски агентов и выполнения инструментов отслеживаются и отображаются в дашборде LangSmith.
Добавьте в файл .env в корне проекта:
LANGSMITH_TRACING=true
LANGSMITH_API_KEY=lsv2_pt_xxxxxxxxxxxxxxxx
LANGSMITH_PROJECT=deer-flow
LANGSMITH_ENDPOINT по умолчанию https://api.smith.langchain.com и может быть переопределён при необходимости. Устаревшие переменные LANGCHAIN_* (LANGCHAIN_TRACING_V2, LANGCHAIN_API_KEY и т.д.) также поддерживаются для обратной совместимости; LANGSMITH_* имеет приоритет, когда заданы обе.
Трассировка Langfuse
DeerFlow также поддерживает наблюдаемость через Langfuse для запусков, совместимых с LangChain.
Добавьте в файл .env:
LANGFUSE_TRACING=true
LANGFUSE_PUBLIC_KEY=pk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_SECRET_KEY=sk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_BASE_URL=https://cloud.langfuse.com
Если вы используете собственный экземпляр Langfuse, укажите LANGFUSE_BASE_URL в качестве URL вашего развёртывания.
Поля корреляции трасс. Каждый запуск агента аннотируется зарезервированными атрибутами трассировки Langfuse, поэтому страницы Sessions и Users заполняются автоматически:
session_id=thread_idLangGraph — группирует все трассы одного диалогаuser_id= эффективный пользователь изget_effective_user_id()(возвращается кdefaultв режиме без аутентификации)trace_name= assistant id (по умолчаниюlead-agent)tags=[env:<DEER_FLOW_ENV>, model:<model_name>](опускается, если не заданы)metadata.deerflow_trace_id= идентификатор корреляции запросов DeerFlow, всегда совпадающий с заголовком ответаX-Trace-Idтого же запроса (logging.enhance.enabledуправляет только тем, выводится ли этот идентификатор в логи)
Эти поля внедряются в RunnableConfig.metadata в корне вызова графа как для gateway-пути (runtime/runs/worker.py::run_agent), так и для встроенного пути (client.py::DeerFlowClient.stream), поэтому любой LangChain-совместимый callback может их прочитать. Установите DEER_FLOW_ENV (или ENVIRONMENT) для тегирования трасс по среде развёртывания.
Использование обоих провайдеров
Если и LangSmith, и Langfuse включены, DeerFlow подключает оба callback'а трассировки и отправляет одну и ту же активность модели в обе системы.
Если провайдер явно включён, но отсутствуют необходимые учётные данные, или если его callback не может инициализироваться, DeerFlow завершает работу с ошибкой (fail fast) при инициализации трассировки во время создания модели, а сообщение об ошибке указывает провайдера, вызвавшего сбой.
В Docker-развёртываниях трассировка отключена по умолчанию. Установите LANGSMITH_TRACING=true и LANGSMITH_API_KEY в .env для включения.
От Deep Research к Super Agent Harness
DeerFlow начинался как фреймворк для Deep Research, и сообщество вышло далеко за эти рамки. После запуска разработчики строили пайплайны, генерировали презентации, поднимали дашборды, автоматизировали контент. То, чего мы не ожидали.
Стало понятно: DeerFlow не просто research-инструмент. Это harness: runtime, который даёт агентам необходимую инфраструктуру.
Поэтому мы переписали всё с нуля.
DeerFlow 2.0 — это Super Agent Harness «из коробки». Batteries included, полностью расширяемый. Построен на LangGraph и LangChain. По умолчанию есть всё, что нужно агенту: файловая система, memory, skills, sandbox-выполнение и возможность планировать и запускать sub-agents для сложных многошаговых задач.
Используйте как есть. Или разберите и переделайте под себя.
Core Features
Skills & Tools
Skills — это то, что позволяет DeerFlow делать почти что угодно.
Agent Skill — это структурированный модуль: Markdown-файл с описанием воркфлоу, лучших практик и ссылок на ресурсы. DeerFlow поставляется со встроенными skills для ресёрча, генерации отчётов, слайдов, веб-страниц, изображений и видео. Но главное — расширяемость: добавляйте свои skills, заменяйте встроенные или собирайте из них составные воркфлоу.
Skills загружаются по мере необходимости, только когда задача их требует. Это держит контекстное окно чистым.
# Пути внутри контейнера sandbox
/mnt/skills/public
├── research/SKILL.md
├── report-generation/SKILL.md
├── slide-creation/SKILL.md
├── web-page/SKILL.md
└── image-generation/SKILL.md

/mnt/skills/custom
└── your-custom-skill/SKILL.md      ← ваш skill
Интеграция с Claude Code
Skill claude-to-deerflow позволяет работать с DeerFlow прямо из Claude Code. Отправляйте задачи, проверяйте статус, управляйте тредами, не выходя из терминала.
Установка скилла:
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
Что можно делать:
- Отправлять сообщения в DeerFlow и получать потоковые ответы
- Выбирать режимы выполнения: flash (быстро), standard, pro (planning), ultra (sub-agents)
- Проверять статус DeerFlow, просматривать модели, скиллы, агентов
- Управлять тредами и историей диалога
- Загружать файлы для анализа
Полный справочник API в skills/public/claude-to-deerflow/SKILL.md.
Цели сессии (Session Goals)
Используйте /goal <условие завершения>, чтобы привязать к текущему треду одно активное условие завершения. Цель — это состояние уровня треда, а не активация навыка, поэтому она остаётся активной между ходами, пока DeerFlow не сочтёт её выполненной или пока вы её не очистите.
Поддерживаемые команды:
/goal finish the implementation and make all tests pass
/goal              # показать активную цель
/goal clear        # очистить её
После каждого запуска, выполненного через Gateway, DeerFlow оценивает видимый диалог относительно активной цели с помощью non-thinking модели-оценщика. Оценщик должен вернуть типизированный блокер (missing_evidence, needs_user_input, run_failed, external_wait или goal_not_met_yet) с видимыми доказательствами. DeerFlow добавляет hidden continuation только тогда, когда последний ход assistant сохранён в чекпоинте, блокер имеет тип goal_not_met_yet, тред не изменился во время оценки и счётчик отсутствия прогресса не сработал. Предел безопасности по умолчанию — 8 hidden continuation, а повторяющиеся одинаковые оценки без прогресса останавливаются после 2 попыток. /goal clear и любой новый ввод от пользователя имеют приоритет над continuation в очереди. Когда цель выполнена, DeerFlow очищает её автоматически и публикует обновлённое состояние треда.
Веб-интерфейс показывает активную цель над полем ввода. Та же команда доступна из TUI и поддерживаемых IM-каналов. В веб-интерфейсе и поддерживаемых IM-каналах установка /goal <условие завершения> также запускает выполнение с условием в качестве задачи; команды статуса и очистки только управляют состоянием цели.
Sub-Agents
Сложные задачи редко решаются за один проход. DeerFlow их декомпозирует.
Lead agent запускает sub-agents на лету, каждый со своим изолированным контекстом, инструментами и условиями завершения. Sub-agents работают параллельно, возвращают структурированные результаты, а lead agent собирает всё в единый итог.
Вот как DeerFlow справляется с задачами на минуты и часы: research-задача разветвляется в дюжину sub-agents, каждый копает свой угол, потом всё сходится в один отчёт, или сайт, или слайддек со сгенерированными визуалами. Один harness, много рук.
Sandbox & файловая система
DeerFlow не просто говорит о том, что умеет что-то делать. У него есть собственный компьютер.
Каждая задача выполняется внутри изолированного Docker-контейнера с полной файловой системой: skills, workspace, uploads, outputs. Агент читает, пишет и редактирует файлы. Выполняет bash-команды и пишет код. Смотрит на изображения. Всё изолировано, всё прозрачно, никакого пересечения между сессиями.
Это разница между чатботом с доступом к инструментам и агентом с реальной средой выполнения.
# Пути внутри контейнера sandbox
/mnt/user-data/
├── uploads/          ← ваши файлы
├── workspace/        ← рабочая директория агентов
└── outputs/          ← результаты
Context Engineering
Изолированный контекст: каждый sub-agent работает в своём контексте и не видит контекст главного агента или других sub-agents. Агент фокусируется на своей задаче.
Управление контекстом: внутри сессии DeerFlow агрессивно сжимает контекст и суммирует завершённые подзадачи, выгружает промежуточные результаты в файловую систему, сжимает то, что уже не актуально. На длинных многошаговых задачах контекстное окно не переполняется.
Long-Term Memory
Большинство агентов забывают всё, когда диалог заканчивается. DeerFlow помнит.
DeerFlow сохраняет ваш профиль, предпочтения и накопленные знания между сессиями. Чем больше используете, тем лучше он вас знает: стиль, технологический стек, повторяющиеся воркфлоу. Всё хранится локально и остаётся под вашим контролем.
Рекомендуемые модели
DeerFlow работает с любым LLM через OpenAI-совместимый API. Лучше всего — с моделями, которые поддерживают:
- Большое контекстное окно (100k+ токенов) — для deep research и многошаговых задач
- Reasoning capabilities — для адаптивного планирования и сложной декомпозиции
- Multimodal inputs — для работы с изображениями и видео
- Strong tool-use — для надёжного вызова функций и структурированных ответов
Встроенный Python-клиент
DeerFlow можно использовать как Python-библиотеку прямо в коде — без запуска HTTP-сервисов. DeerFlowClient даёт доступ ко всем возможностям агента и Gateway, возвращает те же схемы ответов, что и HTTP Gateway API. HTTP Gateway также предоставляет DELETE /api/threads/{thread_id} для удаления локальных данных треда, управляемых DeerFlow, после того как сам LangGraph thread был удалён:
from deerflow.client import DeerFlowClient

client = DeerFlowClient()

# Chat
response = client.chat("Analyze this paper for me", thread_id="my-thread")

# Streaming (LangGraph SSE protocol: values, messages-tuple, end)
for event in client.stream("hello"):
    if event.type == "messages-tuple" and event.data.get("type") == "ai":
        print(event.data["content"])

# Configuration & management — returns Gateway-aligned dicts
models = client.list_models()        # {"models": [...]}
skills = client.list_skills()        # {"skills": [...]}
client.update_skill("web-search", enabled=True)
client.upload_files("thread-1", ["./report.pdf"])  # {"success": True, "files": [...]}
client.set_goal("thread-1", "finish the implementation and make all tests pass")
client.get_goal("thread-1")       # {"goal": {...}} or {"goal": None}
client.clear_goal("thread-1")
Запланированные задачи (Scheduled Tasks)
Теперь в DeerFlow есть первоклассный MVP запланированных задач (scheduled-task) в workspace.
Текущие возможности MVP:
- Управление задачами на
/workspace/scheduled-tasks - Выбор: каждая запланированная задача переиспользует тред или создаёт новый тред для каждого запуска
- Поддержка расписаний
onceиcron - Фоновые запланированные запуски выполняются как неинтерактивные запуски DeerFlow (
ask_clarificationтам не предоставляется) - При совпадении наступившего cron-запуска с активным запуском на том же переиспользуемом треде применяется поведение перекрытия
skip - Приостановка, возобновление, ручной запуск, просмотр истории и удаление задач
- Запланированные задачи выполняются через стандартный жизненный цикл запуска DeerFlow
Текущие ограничения MVP:
- Пока нет инструмента
schedule_task, создающего задачи в диалоге - Нет заданий с текстовыми уведомлениями
- Нет каналов или целей отправки GitHub
- В этой первой версии нет типа расписания
interval
Включите фоновый опрос через config.yaml -> scheduler.enabled. Ручной запуск использует тот же ресурс и путь выполнения scheduled-task.
Терминальная панель (TUI)
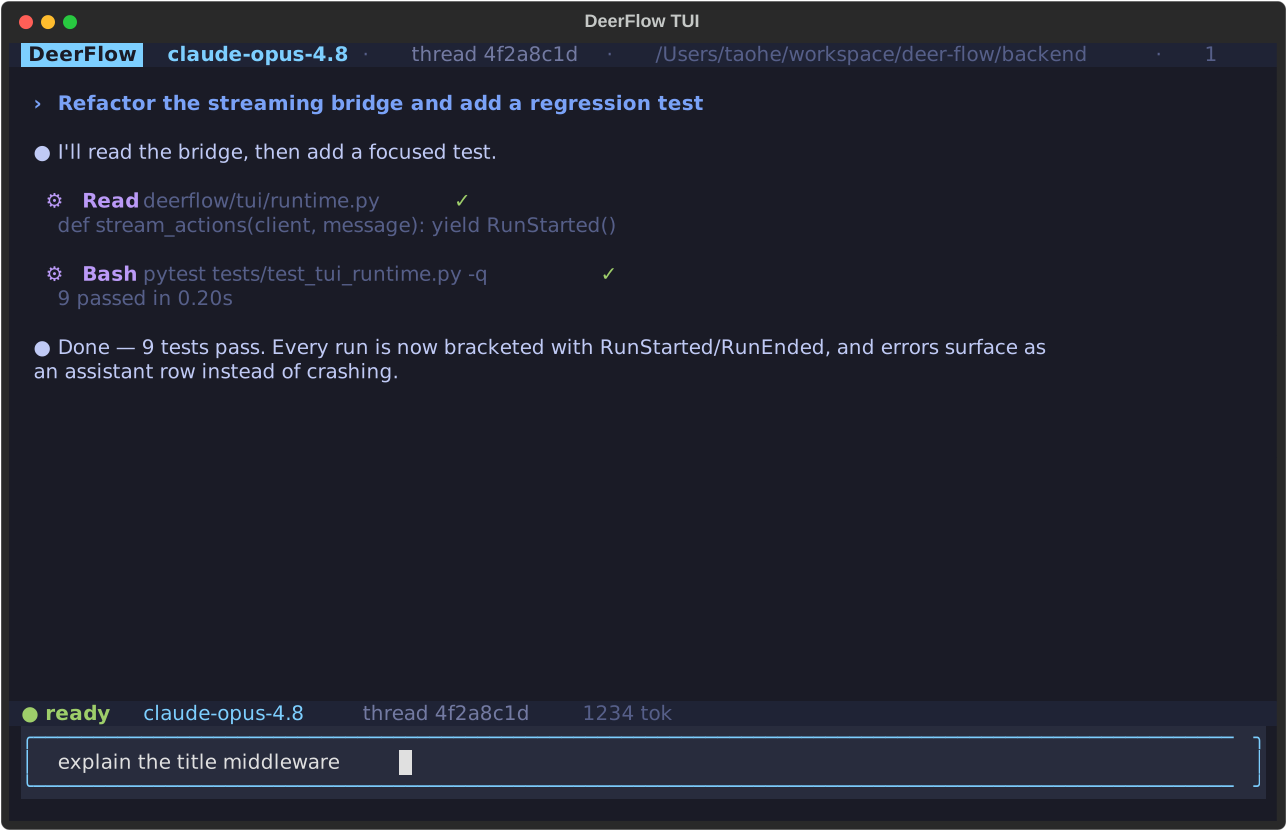
deerflow — это нативная терминальная панель для тех, кто живёт в шелле. Она работает встроенной поверх DeerFlowClient — без Gateway, фронтенда, nginx или Docker — и при этом учитывает те же настройки config.yaml, checkpointer, skills, memory, MCP и sandbox, что и остальной DeerFlow.
uv pip install 'deerflow-harness[tui]'        # опциональная зависимость 'textual'

deerflow                                      # запустить терминальный UI (требуется TTY)
deerflow --continue                           # возобновить последний тред
deerflow --resume THREAD                      # возобновить тред по id
deerflow --print "summarize this repo"        # автономный разовый ответ в stdout
deerflow --json  "hello"                       # автономный режим, StreamEvents с разделением новой строкой
Интерфейс чата с управлением с клавиатуры: потоковый транскрипт (ответы рендерятся в Markdown), компактные карточки активности инструментов, палитра слэш-команд /, управление целями /goal, селекторы /model и /threads, история ввода, а также прерывание через Esc / Ctrl+C. Сессии, открытые в TUI, также появляются в боковой панели веб-интерфейса — TUI пишет в общее хранилище тредов под локальным пользователем по умолчанию, поэтому терминал и веб остаются синхронизированными без запуска Gateway.
Полное руководство — в backend/docs/TUI.md.
Документация
- Руководство по участию — настройка среды разработки, воркфлоу и гайдлайны
- Руководство по конфигурации — инструкции по настройке
- Обзор архитектуры — технические детали
- Архитектура бэкенда — бэкенд и справочник API
⚠️ Безопасность
Неправильное развёртывание может привести к угрозам безопасности
DeerFlow обладает ключевыми высокопривилегированными возможностями, включая выполнение системных команд, операции с ресурсами и вызов бизнес-логики. По умолчанию он рассчитан на развёртывание в локальной доверенной среде (доступ только через loopback-адрес 127.0.0.1). Если вы разворачиваете агент в недоверенных средах — локальных сетях, публичных облачных серверах или других окружениях, доступных с нескольких устройств — без строгих мер безопасности, это может привести к следующим угрозам:
- Несанкционированные вызовы: функциональность агента может быть обнаружена неавторизованными третьими лицами или вредоносными сканерами, что приведёт к массовым несанкционированным запросам с выполнением высокорисковых операций (системные команды, чтение/запись файлов) и серьёзным последствиям для безопасности.
- Юридические и compliance-риски: если агент будет незаконно использован для кибератак, кражи данных или других противоправных действий, это может повлечь юридическую ответственность и compliance-риски.
Рекомендации по безопасности
Примечание: настоятельно рекомендуем развёртывать DeerFlow только в локальной доверенной сети. Если вам необходимо развёртывание через несколько устройств или сетей, обязательно реализуйте строгие меры безопасности, например:
- Белый список IP-адресов: используйте
iptablesили аппаратные межсетевые экраны / коммутаторы с ACL, чтобы настроить правила белого списка IP и заблокировать доступ со всех остальных адресов. - Шлюз аутентификации: настройте обратный прокси (nginx и др.) и включите строгую предварительную аутентификацию, запрещающую любой доступ без авторизации.
- Сетевая изоляция: по возможности разместите агент и доверенные устройства в одном выделенном VLAN, изолированном от остальной сети.
- Следите за обновлениями: регулярно отслеживайте обновления безопасности проекта DeerFlow.
Участие в разработке
Приветствуем контрибьюторов! Настройка среды разработки, воркфлоу и гайдлайны — в CONTRIBUTING.md.
Лицензия
Проект распространяется под лицензией MIT.
Благодарности
DeerFlow стоит на плечах open-source сообщества. Спасибо всем проектам и разработчикам, чья работа сделала его возможным.
Отдельная благодарность:
- LangChain — фреймворк для взаимодействия с LLM и построения цепочек.
- LangGraph — многоагентная оркестрация, на которой держатся сложные воркфлоу DeerFlow.
Ключевые контрибьюторы
Авторы DeerFlow, без которых проекта бы не было: