 9146bfa03d
* refactor(gateway): issue request trace ids unconditionally

The request trace id was gated behind logging.enhance.enabled at every
entry point, so downstream code had to keep asking whether one existed:
a header-provenance flag in its own ContextVar, a precedence resolver,
and three-level carrier fallbacks at each consumer.

Bind one unconditionally instead. TraceMiddleware covers Gateway HTTP;
ensure_trace_context covers the entry points that never touch ASGI --
scheduled occurrences, MCP task notification runs, IM channel messages,
and the embedded client -- each scoped to one unit of work so a
long-lived worker task cannot leak one occurrence's id into the next.
The ContextVar becomes the only source; the response header, runtime
context, run metadata and log records are derived outputs.

Consumers now use ensure_trace_id() or resolve_trace_id(*carriers) and
drop their presence guards. Removed: resolve_deerflow_trace_id, the
header-provenance flag and its three helpers, set/reset_current_trace_id,
is_trace_correlation_enabled and its gateway alias.

BREAKING CHANGE: every Gateway HTTP response now carries X-Trace-Id and
it cannot be turned off; logging.enhance.enabled controls log output
only. Installations on the default enabled: false will start seeing the
header. No config keys were added or removed.

* fix(gateway): stop persisting a caller-supplied trace id on the run record

body.metadata forks two ways: through build_run_config into the live run
config, which the run worker restamps, and through create_or_reject into
the run record that the runs API echoes verbatim. Only the first was
covered, so a client sending metadata.deerflow_trace_id made the most
durable and most visible surface of a run disagree with the X-Trace-Id
and the log lines the same request produced -- a correlation id that
does not match the logs is worse than none.

Stamp the server-issued id once at the trust boundary so both forks
receive it, preserving the caller's own metadata keys. Close the same
gap on config.context, which reaches the runtime context by a separate
path: _build_runtime_context no longer merges server-owned keys from the
caller, and _install_runtime_context assigns rather than setdefaults.

A thread's metadata is no longer seeded with the run-scoped id of
whichever run created it -- one thread spans many runs and as many
trace ids.

Found by driving a real run through the Gateway and reading the run back
from the runs API; every unit test built its metadata by hand and so
could not see it.

* fix(gateway): expose X-Trace-Id to split-origin browser clients

X-Trace-Id is not on the CORS safelist, so a browser client served from
a separate origin could not read it -- and those are exactly the clients
that cannot read the Gateway's logs either, leaving them with nothing to
quote in a bug report. Same-origin nginx deployments were unaffected,
which is why this stayed hidden.

Add it to CORS_EXPOSED_HEADERS beside Content-Location, referencing
TRACE_ID_HEADER rather than repeating the literal.

* fix(gateway): keep X-Trace-Id on unhandled-exception 500s

Starlette's ServerErrorMiddleware sits outside every user middleware and
emits unhandled-exception 500s through the raw send, so those responses
never pass TraceMiddleware's header-writing wrapper. The 500 for a server
bug is exactly the response a user most needs to correlate with a log line,
and it was the one response that shipped without the id.

TraceMiddleware now tracks whether http.response.start has been sent. On an
exception with no response started it emits its own plain 500 carrying the
header, then re-raises: the outer ServerErrorMiddleware sees the response
already started and only re-raises too, so the server's exception logging is
untouched. An exception mid-stream keeps propagating unchanged — a second
response start cannot be sent, and the already-written header stands.

The trace id is printable ASCII by construction (normalize_trace_id /
generate_trace_id), which is what makes the raw latin-1 header encoding
safe.

* fix(gateway): strip the forged trace id from the persisted request echo

The run-record fix stopped a forged metadata.deerflow_trace_id on the
authoritative metadata surface, but the raw request echo still carried one:
create_or_reject persists body.config verbatim as runs.kwargs_json, which
the runs API serves back. A client posting config.context.deerflow_trace_id
therefore still got its forged value stored and echoed on one API surface
while the header, logs, run metadata, and checkpoint all carried the real
id — the id is ignored as input there, so echoing it back only manufactures
disagreement.

Two changes close it. redact_config_secrets — already the shared scrub for
that echo, applied at admission and again at serve time, so historical
records are covered too — now also drops deerflow_trace_id from
config.metadata and config.context. And build_run_config now merges run
metadata onto a copy of the caller's config["metadata"] instead of updating
it in place: the nested values of the request config are reference copies,
so the in-place merge was writing the server-stamped key through into
body.config, contaminating the "what the client sent" record before it was
persisted (and incidentally masking the forged-value echo on the metadata
container).

The regression test posts a forged id through body.metadata,
config.metadata, and config.context at once and reads the kwargs echo back
off the run record, failing if either leak returns.

* docs(harness): record the trace-echo scrub, 500 fallback, and accepted retry divergence

The trace section of the harness AGENTS.md now covers the two fixes that
close the derived-output rule (the kwargs-echo scrub in
redact_config_secrets plus build_run_config's copy merge, and
TraceMiddleware's own 500 for unhandled exceptions), and CHANGELOG gains
their Fixed entries.

It also writes down the one accepted divergence: a crash-recovered
scheduled launch reuses the durable run through its idempotency key, and
start_run returns early on idempotency_reused without restamping — so the
run record keeps the first attempt's deerflow_trace_id while the retry's
own log lines carry the freshly minted id of its ensure_trace_context
binding. The divergence is confined to the crash-recovery window and is
accepted rather than fixed: restamping on reuse would rewrite a persisted
record for a run that already exists, which is worse than two ids that each
correlate their own attempt's logs. Written down so the next reader of the
scheduler recovery path does not diagnose it as a bug.

* docs(config): align the logging.enhance schema note with the unconditional trace id

The config-module AGENTS.md still described logging.enhance as the gate for
the Gateway X-Trace-Id header and Langfuse deerflow_trace_id. That model is
gone: ids are issued unconditionally and this block decides log output only.
Left as-is, the stale wording invites an agent to "restore" a header gate it
believes was lost. Reworded to match the sibling AGENTS.md files and
config.example.yaml, with a pointer to the Request Trace Context section
that owns the full model.

* docs(changelog): link the trace entries to #5119

The five new entries pointed at the ([#XXXX]) placeholder with no reference
definition, rendering as literal text instead of a link — and RELEASING.md
step 2 relies on those references when the section becomes release notes.
All five now point at #5119, with the definition appended to the reference
block.

* refactor(harness): rename _stream_without_trace_context to _stream_turn

The name asserted the opposite of what the method now does. It was accurate
while logging.enhance.enabled could route stream() around the trace scope;
with the gate gone it is the only stream implementation left, and it binds
the id itself via ensure_trace_id(). Private, so the rename touches only the
definition and the one stream() call site.

* docs(harness): fit the trace-context guidance inside the AGENTS.md chain budget

The expanded Request Trace Context section pushed the effective AGENTS.md
chain for agents/middlewares to 99,815 bytes, past the 98,304 hard limit
scripts/check_agent_guidance.py enforces in CI (AG002). Compressed the
section from 7,359 to 4592 bytes with no facts removed: the entry-point
table, the derived-output rule and its enforcement points, the accepted
scheduled-retry divergence, the two resolution helpers, the stream()
binding rationale, the log-output-only gate, the CORS listing, the 500
fallback, and the test map all remain.

Sized against the merge, not just the branch: current main grew the same
chain by ~724 bytes, so the check was verified on the merged tree as well
(97,772 bytes; branch tree 97,048).

* fix(gateway): declare content-length on the fallback 500

The pre-response 500 declared content-type but no content-length, leaving
the framing to the ASGI server: chunked on HTTP/1.1, close-delimited on
HTTP/1.0 — the one wire difference from the ServerErrorMiddleware response
it replaces, which sends content-length: 21. The explicit header keeps the
fallback byte-identical to what clients saw before.

* docs(readme): drop the trace-correlation condition from the translations

The zh/ja/fr/ru Langfuse sections still said metadata.deerflow_trace_id
matches X-Trace-Id "when request trace correlation is enabled". The id now
always matches and that condition no longer exists, so each bullet states
the unconditional match and that logging.enhance.enabled only controls
whether the id is printed into logs — the one piece of the feature a user
can still configure.

* test(gateway): pin TraceMiddleware wiring through create_app()

Every X-Trace-Id test exercised a hand-built four-route app, so the real
stack's add_middleware(TraceMiddleware) line was pinned by nothing: deleting
it — or short-circuiting above it — passed CI while silently dropping both
the response header and the ambient id the run-record stamp and enhanced log
records derive from. One case now drives /health through create_app() and
asserts the inbound id round-trips; mutation-checked by removing the wiring
line, which fails exactly this test.

* docs(gateway): note the fallback 500 is CORS-opaque

The pre-response 500 is emitted outside CORSMiddleware — the exception has
already unwound past it — so it carries no Access-Control-Allow-Origin and
a split-origin browser client cannot read the id on this one response,
unchanged from the ServerErrorMiddleware 500 it replaces. Documented on the
class and in the CHANGELOG entry rather than fixed: replicating the origin
allowlist outside CORSMiddleware would let the two policies drift.

* fix(harness): keep abandoned-stream cleanup inside the trace binding

stream() binds the turn's id around each next(inner) and resets it before
yielding, but the finally's inner.close() ran after that binding was gone.
Abandoning the stream therefore drove the inner LangGraph generator's
GeneratorExit/finally path with no trace id — or an unrelated ambient one
from whichever context ran the close — so cancellation and finalization
logs and callbacks did not correlate with the turn they belong to.

inner.close() is now wrapped in a local bind/reset of the same turn id. The
token is set and reset in the same frame, never across a yield, so the
per-step cross-context safety is preserved even when GC closes the
generator from another Context — pinned by the existing copy_context close
test, which now exercises this path. The regression test records the id
from the inner generator's finally and fails without the binding.

* test(harness): teach the worker-trace fake about RunManager.cleanup

Upstream #5112 (bound gateway memory after terminal runs) added a
run_manager.cleanup(run_id) call to run_agent's finalization, so the
merge-commit CI run failed all five worker-trace-binding tests with
AttributeError on this PR's _FakeRunManager. The fake gains the same no-op
shape as its other methods.

* docs(gateway): bring the gateway AGENTS.md back under its soft budget

Upstream #5092 grew backend/app/gateway/AGENTS.md to 40,966 bytes, 6 over
the 40,960 soft budget that
test_agent_guidance_check.py::test_repository_guidance_stays_below_soft_budgets_and_avoids_doc_indexes
enforces — its Unit Tests run on main was cancelled by push concurrency, so
main is currently red on that test and every PR merge-run inherits the
failure. Two whitespace/wording trims in the row #5092 touched (a doubled
space, and "its configured `context_window`" → "its `context_window`")
bring the file to 40,953 with no content change.

---------

Co-authored-by: Willem Jiang <willem.jiang@gmail.com>
45 KiB
🦌 DeerFlow - 2.0
English | 中文 | 日本語 | Français | Русский

Le 28 février 2026, DeerFlow a décroché la 🏆 1re place sur GitHub Trending suite au lancement de la version 2. Un immense merci à notre incroyable communauté — c'est grâce à vous ! 💪🔥
DeerFlow (Deep Exploration and Efficient Research Flow) est un super agent harness open source qui orchestre des sub-agents, de la mémoire et des sandboxes pour accomplir pratiquement n'importe quelle tâche — le tout propulsé par des skills extensibles.
https://github.com/user-attachments/assets/a8bcadc4-e040-4cf2-8fda-dd768b999c18
Note
DeerFlow 2.0 est une réécriture complète. Il ne partage aucun code avec la v1. Si vous cherchez le framework Deep Research original, il est maintenu sur la branche
1.x— les contributions y sont toujours les bienvenues. Le développement actif a migré vers la 2.0.
Site officiel
Découvrez-en plus et regardez des démos réelles sur notre site officiel.
Projets associés
- LLM Space - Découvrez notre arme secrète derrière DeerFlow — un outil de bureau pour prototyper des idées d'agents, inspecter chaque étape du harness, rejouer les échecs et tester les performances.
Coding Plan de ByteDance Volcengine
- Nous recommandons fortement d'utiliser Doubao-Seed-2.0-Code, DeepSeek v3.2 et Kimi 2.5 pour exécuter DeerFlow
- En savoir plus
- Développeurs en Chine continentale, cliquez ici
InfoQuest
DeerFlow intègre désormais le toolkit de recherche et de crawling intelligent développé par BytePlus — InfoQuest (essai gratuit en ligne)
Table des matières
- 🦌 DeerFlow - 2.0
- Site officiel
- Coding Plan de ByteDance Volcengine
- InfoQuest
- Table des matières
- Installation en une phrase pour un coding agent
- Démarrage rapide
- Du Deep Research au Super Agent Harness
- Fonctionnalités principales
- Modèles recommandés
- Client Python intégré
- Tâches planifiées (Scheduled Tasks)
- Atelier terminal (TUI)
- Documentation
- ⚠️ Avertissement de sécurité
- Contribuer
- Licence
- Remerciements
- Star History
Installation en une phrase pour un coding agent
Si vous utilisez Claude Code, Codex, Cursor, Windsurf ou un autre coding agent, vous pouvez simplement lui envoyer cette phrase :
Aide-moi à cloner DeerFlow si nécessaire, puis à initialiser son environnement de développement local en suivant https://raw.githubusercontent.com/bytedance/deer-flow/main/Install.md
Ce prompt est destiné aux coding agents. Il leur demande de cloner le dépôt si nécessaire, de privilégier Docker quand il est disponible, puis de s'arrêter avec la commande exacte pour lancer DeerFlow et la liste des configurations encore manquantes.
Démarrage rapide
Configuration
-
Cloner le dépôt DeerFlow
git clone https://github.com/bytedance/deer-flow.git cd deer-flow -
Lancer l'assistant de configuration (recommandé)
Depuis le répertoire racine du projet (
deer-flow/), exécutez :make setupCette commande lance un assistant interactif qui vous guide dans le choix d'un fournisseur LLM, d'une recherche web optionnelle et des préférences d'exécution/sécurité (mode sandbox, accès bash, outils d'écriture de fichiers). Il génère un
config.yamlminimal et écrit vos clés dans.env. Comptez environ 2 minutes.Exécutez
make doctorà tout moment pour vérifier votre configuration et obtenir des pistes de correction concrètes. Si vous ouvrez une issue GitHub à propos d'un problème de configuration ou d'exécution en local, exécutezmake support-bundle. La commande affiche les prochaines étapes pour le rapporteur, écrit un fichier*-issue-summary.mdà coller dans l'issue, un fichier*-issue-draft.mddestiné au dépôt d'issue assisté par IA, ainsi qu'un zip de preuves optionnel sous.deer-flow/support-bundles/. Si un assistant IA dépose l'issue, partez du brouillon et remplacez chaque placeholder REQUIRED au lieu d'inventer les informations manquantes. N'attachez le zip que si un mainteneur le demande, ou si le résumé seul ne suffit pas. Les mainteneurs et les outils de triage IA peuvent commencer partriage.json; le bundle ne contient que des diagnostics expurgés et des manifestes de fichiers, et n'inclut ni.env, ni les messages bruts des conversations, ni le contenu des fichiers de l'utilisateur.Configuration avancée / manuelle : si vous préférez éditer
config.yamldirectement, exécutez plutôtmake configpour copier le template complet. Voirconfig.example.yamlpour la référence complète, y compris les providers basés sur un CLI (Codex CLI, Claude Code OAuth), OpenRouter, l'API Responses, et plus encore.Exemples de configuration manuelle des modèles
models:
  - name: gpt-4o
    display_name: GPT-4o
    use: langchain_openai:ChatOpenAI
    model: gpt-4o
    api_key: $OPENAI_API_KEY

  - name: openrouter-gemini-2.5-flash
    display_name: Gemini 2.5 Flash (OpenRouter)
    use: langchain_openai:ChatOpenAI
    model: google/gemini-2.5-flash-preview
    api_key: $OPENROUTER_API_KEY
    base_url: https://openrouter.ai/api/v1

  - name: gpt-5-responses
    display_name: GPT-5 (Responses API)
    use: langchain_openai:ChatOpenAI
    model: gpt-5
    api_key: $OPENAI_API_KEY
    use_responses_api: true
    output_version: responses/v1

  - name: qwen3-32b-vllm
    display_name: Qwen3 32B (vLLM)
    use: deerflow.models.vllm_provider:VllmChatModel
    model: Qwen/Qwen3-32B
    api_key: $VLLM_API_KEY
    base_url: http://localhost:8000/v1
    supports_thinking: true
    when_thinking_enabled:
      extra_body:
        chat_template_kwargs:
          enable_thinking: true
OpenRouter et les passerelles compatibles OpenAI similaires doivent être configurés avec
langchain_openai:ChatOpenAIetbase_url. Si vous préférez utiliser un nom de variable d'environnement propre au fournisseur, pointezapi_keyvers cette variable explicitement (par exempleapi_key: $OPENROUTER_API_KEY).Pour router les modèles OpenAI via
/v1/responses, continuez d'utiliserlangchain_openai:ChatOpenAIet définissezuse_responses_api: trueavecoutput_version: responses/v1.Pour vLLM 0.19.0, utilisez
deerflow.models.vllm_provider:VllmChatModel. Pour les modèles de raisonnement de type Qwen, DeerFlow active le raisonnement viaextra_body.chat_template_kwargs.enable_thinkinget préserve le champ non standardreasoningde vLLM au fil des conversations multi-tours avec appels d'outils. Les anciennes configurationsthinkingsont normalisées automatiquement pour assurer la rétrocompatibilité. Les modèles de raisonnement peuvent aussi exiger que le serveur soit démarré avec--reasoning-parser .... Si votre déploiement vLLM local accepte n'importe quelle clé API non vide, vous pouvez tout de même définirVLLM_API_KEYavec une valeur factice.Exemples de providers basés sur un CLI :
models: - name: gpt-5.4 display_name: GPT-5.4 (Codex CLI) use: deerflow.models.openai_codex_provider:CodexChatModel model: gpt-5.4 supports_thinking: true supports_reasoning_effort: true - name: claude-sonnet-4.6 display_name: Claude Sonnet 4.6 (Claude Code OAuth) use: deerflow.models.claude_provider:ClaudeChatModel model: claude-sonnet-4-6 max_tokens: 4096 supports_thinking: true- Codex CLI lit
~/.codex/auth.json - Claude Code accepte
CLAUDE_CODE_OAUTH_TOKEN,ANTHROPIC_AUTH_TOKEN,CLAUDE_CODE_CREDENTIALS_PATH, ou~/.claude/.credentials.json - Les entrées d'agents ACP sont distinctes des providers de modèles — si vous configurez
acp_agents.codex, pointez-le vers un adaptateur Codex ACP tel quenpx -y @zed-industries/codex-acp - Sur macOS, exportez l'auth Claude Code explicitement si nécessaire :
eval "$(python3 scripts/export_claude_code_oauth.py --print-export)"Les clés API peuvent aussi être définies manuellement dans
.env(recommandé) ou exportées dans votre shell :OPENAI_API_KEY=your-openai-api-key TAVILY_API_KEY=your-tavily-api-key - Codex CLI lit
Lancer l'application
Option 1 : Docker (recommandé)
Développement (hot-reload, montage des sources) :
make docker-init    # Pull sandbox image (only once or when image updates)
make docker-start   # Start services (auto-detects sandbox mode from config.yaml)
make docker-start ne lance provisioner que si config.yaml utilise le mode provisioner (sandbox.use: deerflow.community.aio_sandbox:AioSandboxProvider avec provisioner_url).
Les processus backend récupèrent automatiquement les changements dans config.yaml au prochain accès à la configuration, donc les mises à jour de métadonnées des modèles ne nécessitent pas de redémarrage manuel en développement.
Tip
Sous Linux, si les commandes Docker échouent avec
permission denied while trying to connect to the Docker daemon socket at unix:///var/run/docker.sock, ajoutez votre utilisateur au groupedockeret reconnectez-vous avant de réessayer. Voir CONTRIBUTING.md pour la solution complète.
Production (build des images en local, montage de la config et des données) :
make up     # Build images and start all production services
make down   # Stop and remove containers
Note
Le runtime d'agent s'exécute actuellement dans la Gateway. nginx réécrit
/api/langgraph/*vers l'API compatible LangGraph servie par la Gateway.
Accès : http://localhost:2026
Voir CONTRIBUTING.md pour le guide complet de développement avec Docker.
Option 2 : Développement local
Si vous préférez lancer les services en local :
Prérequis : complétez d'abord les étapes de « Configuration » ci-dessus (make setup). make dev nécessite un fichier config.yaml valide à la racine du projet. Définissez DEER_FLOW_PROJECT_ROOT pour indiquer explicitement cette racine, ou DEER_FLOW_CONFIG_PATH pour pointer vers un fichier de configuration précis. L'état d'exécution est écrit par défaut dans .deer-flow sous la racine du projet et peut être déplacé avec DEER_FLOW_HOME ; les skills sont lus par défaut depuis skills/ sous la racine du projet et peuvent être déplacés avec DEER_FLOW_SKILLS_PATH. Exécutez make doctor pour vérifier votre configuration avant de démarrer.
Sous Windows, exécutez le flux de développement local depuis Git Bash. Les shells natifs cmd.exe et PowerShell ne sont pas pris en charge pour les scripts de service basés sur bash, et WSL n'est pas garanti car certains scripts dépendent d'utilitaires de Git for Windows comme cygpath.
-
Vérifier les prérequis :
make check # Verifies Node.js 22+, pnpm, uv, nginx -
Installer les dépendances :
make install # Install backend + frontend dependencies -
(Optionnel) Pré-télécharger l'image sandbox :
# Recommended if using Docker/Container-based sandbox make setup-sandbox -
Démarrer les services :
make dev -
Accès : http://localhost:2026
Avancé
Mode Sandbox
DeerFlow supporte plusieurs modes d'exécution sandbox :
- Exécution locale (exécute le code sandbox directement sur la machine hôte)
- Exécution Docker (exécute le code sandbox dans des conteneurs Docker isolés)
- Exécution Docker avec Kubernetes (exécute le code sandbox dans des pods Kubernetes via le service provisioner)
En développement Docker, le démarrage des services suit le mode sandbox défini dans config.yaml. En mode Local/Docker, provisioner n'est pas démarré.
Voir le Guide de configuration Sandbox pour configurer le mode de votre choix.
Serveur MCP
DeerFlow supporte des serveurs MCP et des skills configurables pour étendre ses capacités.
Pour les serveurs MCP HTTP/SSE, les flux de tokens OAuth sont supportés (client_credentials, refresh_token).
Voir le Guide MCP Server pour les instructions détaillées.
Canaux de messagerie
DeerFlow peut recevoir des tâches depuis des applications de messagerie. Les canaux démarrent automatiquement une fois configurés — aucune IP publique n'est requise.
DeerFlow peut aussi exposer des connexions de canaux IM appartenant à l'utilisateur dans l'UI du workspace. Quand channel_connections est activé, les utilisateurs connectés peuvent lier Telegram, Slack, Discord, Feishu/Lark, DingTalk, WeChat ou WeCom depuis la barre latérale / Settings > Channels. Cela réutilise les transports sortants channels.* existants, donc aucune IP publique ni URL de callback provider n'est requise. Les messages IM entrants s'exécutent ensuite sous le compte utilisateur DeerFlow connecté. Voir IM Channel Connections pour la configuration et les notes de sécurité.
| Canal | Transport | Difficulté |
|---|---|---|
| Telegram | Bot API (long-polling) | Facile |
| Slack | Socket Mode | Modérée |
| Feishu / Lark | WebSocket | Modérée |
| Tencent iLink (long-polling) | Modérée | |
| WeCom | WebSocket | Modérée |
| DingTalk | Stream Push (WebSocket) | Modérée |
Configuration dans config.yaml :
channels:
  # LangGraph-compatible Gateway API base URL (default: http://localhost:8001/api)
  langgraph_url: http://localhost:8001/api
  # Gateway API URL (default: http://localhost:8001)
  gateway_url: http://localhost:8001

  # Optional: global session defaults for all mobile channels
  session:
    assistant_id: lead_agent
    config:
      recursion_limit: 100
    context:
      thinking_enabled: true
      is_plan_mode: false
      subagent_enabled: false

  feishu:
    enabled: true
    app_id: $FEISHU_APP_ID
    app_secret: $FEISHU_APP_SECRET
    # domain: https://open.feishu.cn       # China (default)
    # domain: https://open.larksuite.com   # International

  wecom:
    enabled: true
    bot_id: $WECOM_BOT_ID
    bot_secret: $WECOM_BOT_SECRET

  slack:
    enabled: true
    bot_token: $SLACK_BOT_TOKEN     # xoxb-...
    app_token: $SLACK_APP_TOKEN     # xapp-... (Socket Mode)
    allowed_users: []               # empty = allow all

  telegram:
    enabled: true
    bot_token: $TELEGRAM_BOT_TOKEN
    allowed_users: []               # empty = allow all

    # Optional: per-channel / per-user session settings
    session:
      assistant_id: mobile_agent
      context:
        thinking_enabled: false
      users:
        "123456789":
          assistant_id: vip_agent
          config:
            recursion_limit: 150
          context:
            thinking_enabled: true
            subagent_enabled: true

  wechat:
    enabled: false
    bot_token: $WECHAT_BOT_TOKEN
    ilink_bot_id: $WECHAT_ILINK_BOT_ID
    qrcode_login_enabled: true      # optionnel : autorise le bootstrap QR à la première utilisation quand bot_token est absent
    allowed_users: []               # vide = tout le monde autorisé
    polling_timeout: 35
    state_dir: ./.deer-flow/wechat/state
    max_inbound_image_bytes: 20971520
    max_outbound_image_bytes: 20971520
    max_inbound_file_bytes: 52428800
    max_outbound_file_bytes: 52428800

  dingtalk:
    enabled: true
    client_id: $DINGTALK_CLIENT_ID             # ClientId depuis DingTalk Open Platform
    client_secret: $DINGTALK_CLIENT_SECRET     # ClientSecret depuis DingTalk Open Platform
    allowed_users: []                          # vide = tout le monde autorisé
    card_template_id: ""                       # Optionnel : ID de modèle AI Card pour l'effet machine à écrire en streaming
Définissez les clés API correspondantes dans votre fichier .env :
# Telegram
TELEGRAM_BOT_TOKEN=123456789:ABCdefGHIjklMNOpqrSTUvwxYZ

# Slack
SLACK_BOT_TOKEN=xoxb-...
SLACK_APP_TOKEN=xapp-...

# Feishu / Lark
FEISHU_APP_ID=cli_xxxx
FEISHU_APP_SECRET=your_app_secret

# WeChat iLink
WECHAT_BOT_TOKEN=your_ilink_bot_token
WECHAT_ILINK_BOT_ID=your_ilink_bot_id

# WeCom
WECOM_BOT_ID=your_bot_id
WECOM_BOT_SECRET=your_bot_secret

# DingTalk
DINGTALK_CLIENT_ID=your_client_id
DINGTALK_CLIENT_SECRET=your_client_secret
Configuration Telegram
- Ouvrez une conversation avec @BotFather, envoyez
/newbot, et copiez le token HTTP API. - Définissez
TELEGRAM_BOT_TOKENdans.envet activez le canal dansconfig.yaml.
Configuration Slack
- Créez une Slack App sur api.slack.com/apps → Create New App → From scratch.
- Dans OAuth & Permissions, ajoutez les Bot Token Scopes :
app_mentions:read,chat:write,im:history,im:read,im:write,files:write. - Activez le Socket Mode → générez un App-Level Token (
xapp-…) avec le scopeconnections:write. - Dans Event Subscriptions, abonnez-vous aux bot events :
app_mention,message.im. - Définissez
SLACK_BOT_TOKENetSLACK_APP_TOKENdans.envet activez le canal dansconfig.yaml.
Configuration Feishu / Lark
- Créez une application sur Feishu Open Platform → activez la capacité Bot.
- Ajoutez les permissions :
im:message,im:message.p2p_msg:readonly,im:resource. - Dans Events, abonnez-vous à
im.message.receive_v1et sélectionnez le mode Long Connection. - Copiez l'App ID et l'App Secret. Définissez
FEISHU_APP_IDetFEISHU_APP_SECRETdans.envet activez le canal dansconfig.yaml.
Configuration WeChat
- Activez le canal
wechatdansconfig.yaml. - Soit définissez
WECHAT_BOT_TOKENdans.env, soit mettezqrcode_login_enabled: truepour le bootstrap QR à la première utilisation. - Quand
bot_tokenest absent et que le bootstrap QR est activé, surveillez les logs du backend pour le contenu du QR renvoyé par iLink et complétez le flux de binding. - Une fois le flux QR réussi, DeerFlow persiste le token acquis sous
state_dirpour les redémarrages ultérieurs. - Pour les déploiements Docker Compose, gardez
state_dirsur un volume persistant afin que le curseurget_updates_bufet l'état d'auth sauvegardé survivent aux redémarrages.
Configuration WeCom
- Créez un bot sur la plateforme WeCom AI Bot et obtenez le
bot_idet lebot_secret. - Activez
channels.wecomdansconfig.yamlet renseignezbot_id/bot_secret. - Définissez
WECOM_BOT_IDetWECOM_BOT_SECRETdans.env. - Assurez-vous que les dépendances du backend incluent
wecom-aibot-python-sdk. Le canal utilise une connexion longue WebSocket et ne nécessite pas d'URL de callback publique. - L'intégration actuelle prend en charge les messages entrants texte, image et fichier. Les images/fichiers finaux générés par l'agent sont aussi renvoyés dans la conversation WeCom.
Configuration DingTalk
- Créez une application sur DingTalk Open Platform et activez la capacité Robot.
- Dans la page de configuration du robot, définissez le mode de réception des messages sur Stream.
- Copiez le
Client IDet leClient Secret. DéfinissezDINGTALK_CLIENT_IDetDINGTALK_CLIENT_SECRETdans.envet activez le canal dansconfig.yaml. - (Optionnel) Pour activer les réponses en streaming AI Card (effet machine à écrire), créez un modèle AI Card sur la plateforme de cartes DingTalk, puis définissez
card_template_iddansconfig.yamlavec l'ID du modèle. Vous devez également demander les permissionsCard.Streaming.WriteetCard.Instance.Write.
Commandes
Une fois un canal connecté, vous pouvez interagir avec DeerFlow directement depuis le chat :
| Commande | Description |
|---|---|
/new |
Démarrer une nouvelle conversation |
/status |
Afficher les infos du thread en cours |
/models |
Lister les modèles disponibles |
/memory |
Consulter la mémoire |
/help |
Afficher l'aide |
Les messages sans préfixe de commande sont traités comme du chat classique — DeerFlow crée un thread et répond de manière conversationnelle.
Traçage LangSmith
DeerFlow intègre nativement LangSmith pour l'observabilité. Une fois activé, tous les appels LLM, les exécutions d'agents et les exécutions d'outils sont tracés et visibles dans le tableau de bord LangSmith.
Ajoutez les lignes suivantes à votre fichier .env :
LANGSMITH_TRACING=true
LANGSMITH_ENDPOINT=https://api.smith.langchain.com
LANGSMITH_API_KEY=lsv2_pt_xxxxxxxxxxxxxxxx
LANGSMITH_PROJECT=xxx
Traçage Langfuse
DeerFlow prend également en charge l'observabilité via Langfuse pour les exécutions compatibles LangChain.
Ajoutez les lignes suivantes à votre fichier .env :
LANGFUSE_TRACING=true
LANGFUSE_PUBLIC_KEY=pk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_SECRET_KEY=sk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_BASE_URL=https://cloud.langfuse.com
Si vous utilisez une instance Langfuse auto-hébergée, définissez LANGFUSE_BASE_URL sur l'URL de votre déploiement.
Champs de corrélation des traces. Chaque exécution d'agent est annotée avec les attributs de trace réservés de Langfuse afin que les pages Sessions et Users se remplissent automatiquement :
session_id=thread_idde LangGraph — regroupe toutes les traces d'une même conversationuser_id= utilisateur effectif issu deget_effective_user_id()(revient àdefaulten mode sans authentification)trace_name= assistant id (par défautlead-agent)tags=[env:<DEER_FLOW_ENV>, model:<model_name>](omis lorsqu'ils ne sont pas définis)metadata.deerflow_trace_id= id de corrélation de requête DeerFlow, toujours identique à l'en-tête de réponseX-Trace-Idrenvoyé par la même requête (logging.enhance.enabledcontrôle uniquement si cet id est écrit dans les logs)
Ces champs sont injectés dans RunnableConfig.metadata à la racine de l'invocation du graphe, à la fois pour le chemin gateway (runtime/runs/worker.py::run_agent) et le chemin embarqué (client.py::DeerFlowClient.stream), de sorte que tout callback compatible LangChain puisse les lire. Définissez DEER_FLOW_ENV (ou ENVIRONMENT) pour étiqueter les traces par environnement de déploiement.
Utiliser les deux fournisseurs
Si LangSmith et Langfuse sont tous deux activés, DeerFlow attache les deux callbacks de traçage et rapporte la même activité de modèle aux deux systèmes.
Si un fournisseur est explicitement activé mais qu'il manque les identifiants requis, ou si son callback échoue à s'initialiser, DeerFlow échoue immédiatement (fail fast) lors de l'initialisation du traçage à la création du modèle, et le message d'erreur indique le fournisseur à l'origine de l'échec.
Pour les déploiements Docker, le traçage est désactivé par défaut. Définissez LANGSMITH_TRACING=true et LANGSMITH_API_KEY dans votre .env pour l'activer.
Du Deep Research au Super Agent Harness
DeerFlow a démarré comme un framework de Deep Research — et la communauté s'en est emparée. Depuis le lancement, les développeurs l'ont poussé bien au-delà de la recherche : construction de pipelines de données, génération de présentations, mise en place de dashboards, automatisation de workflows de contenu. Des usages qu'on n'avait jamais anticipés.
Ça nous a révélé quelque chose d'important : DeerFlow n'était pas qu'un simple outil de recherche. C'était un harness — un runtime qui donne aux agents l'infrastructure nécessaire pour vraiment accomplir du travail.
On l'a donc reconstruit de zéro.
DeerFlow 2.0 n'est plus un framework à assembler soi-même. C'est un super agent harness — clé en main et entièrement extensible. Construit sur LangGraph et LangChain, il embarque tout ce dont un agent a besoin out of the box : un système de fichiers, de la mémoire, des skills, une exécution sandboxée, et la capacité de planifier et de lancer des sub-agents pour les tâches complexes et multi-étapes.
Utilisez-le tel quel. Ou démontez-le et faites-en le vôtre.
Fonctionnalités principales
Skills et outils
Les skills sont ce qui permet à DeerFlow de faire pratiquement n'importe quoi.
Un Agent Skill standard est un module de capacité structuré — un fichier Markdown qui définit un workflow, des bonnes pratiques et des références vers des ressources associées. DeerFlow est livré avec des skills intégrés pour la recherche, la génération de rapports, la création de présentations, les pages web, la génération d'images et de vidéos, et bien plus. Mais la vraie force réside dans l'extensibilité : ajoutez vos propres skills, remplacez ceux fournis, ou combinez-les en workflows composites.
Les skills sont chargés progressivement — uniquement quand la tâche le nécessite, pas tous en même temps. Ça permet de garder la fenêtre de contexte légère et de bien fonctionner même avec des modèles sensibles au nombre de tokens.
Quand vous installez des archives .skill via le Gateway, DeerFlow accepte les métadonnées frontmatter optionnelles standard comme version, author et compatibility, plutôt que de rejeter des skills externes par ailleurs valides.
Les outils suivent la même philosophie. DeerFlow est livré avec un ensemble d'outils de base — recherche web, fetch de pages web, opérations sur les fichiers, exécution bash — et supporte les outils custom via des serveurs MCP et des fonctions Python. Remplacez n'importe quoi. Ajoutez n'importe quoi.
Les suggestions de suivi générées par le Gateway normalisent désormais aussi bien la sortie texte brut du modèle que le contenu riche au format bloc/liste avant de parser la réponse en tableau JSON, de sorte que les wrappers de contenu propres à chaque provider ne suppriment plus silencieusement les suggestions.
# Paths inside the sandbox container
/mnt/skills/public
├── research/SKILL.md
├── report-generation/SKILL.md
├── slide-creation/SKILL.md
├── web-page/SKILL.md
└── image-generation/SKILL.md

/mnt/skills/custom
└── your-custom-skill/SKILL.md      ← yours
Intégration Claude Code
Le skill claude-to-deerflow vous permet d'interagir avec une instance DeerFlow en cours d'exécution directement depuis Claude Code. Envoyez des tâches de recherche, vérifiez le statut, gérez les threads — le tout sans quitter le terminal.
Installer le skill :
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
Assurez-vous ensuite que DeerFlow tourne (par défaut sur http://localhost:2026) et utilisez la commande /claude-to-deerflow dans Claude Code.
Ce que vous pouvez faire :
- Envoyer des messages à DeerFlow et recevoir des réponses en streaming
- Choisir le mode d'exécution : flash (rapide), standard, pro (planification), ultra (sub-agents)
- Vérifier la santé de DeerFlow, lister les modèles/skills/agents
- Gérer les threads et l'historique des conversations
- Upload des fichiers pour analyse
Variables d'environnement (optionnel, pour des endpoints custom) :
DEERFLOW_URL=http://localhost:2026            # Unified proxy base URL
DEERFLOW_GATEWAY_URL=http://localhost:2026    # Gateway API
DEERFLOW_LANGGRAPH_URL=http://localhost:2026/api/langgraph  # LangGraph API
Voir skills/public/claude-to-deerflow/SKILL.md pour la référence API complète.
Objectifs de session (Session Goals)
Utilisez /goal <condition de complétion> pour attacher une condition de complétion active au thread courant. Le goal est un état de portée thread, pas une activation de skill — il reste actif entre les tours jusqu'à ce que DeerFlow détermine qu'il a été satisfait, ou jusqu'à ce que vous le supprimiez.
Commandes prises en charge :
/goal finish the implementation and make all tests pass
/goal              # afficher le goal actif
/goal clear        # le supprimer
Après chaque exécution menée par la Gateway, DeerFlow évalue la conversation visible par rapport au goal actif à l'aide d'un modèle évaluateur non-thinking. L'évaluateur doit renvoyer un blocker typé (missing_evidence, needs_user_input, run_failed, external_wait ou goal_not_met_yet) accompagné de preuves visibles. DeerFlow n'injecte une hidden continuation que si le dernier tour assistant est durablement checkpointé, que le blocker est goal_not_met_yet, que le thread n'a pas changé durant l'évaluation et que le disjoncteur de non-progression n'a pas déclenché. Le plafond de sécurité est de 8 hidden continuations par défaut, et les évaluations identiques de non-progression s'arrêtent après 2 tentatives répétées. /goal clear ainsi que toute nouvelle saisie utilisateur ont priorité sur les continuations en file d'attente. Lorsque le goal est satisfait, DeerFlow le supprime automatiquement et publie l'état mis à jour du thread.
Le Web UI affiche le goal actif au-dessus de la zone de saisie. La même commande est disponible depuis le TUI et les canaux IM pris en charge. Dans le Web UI et les canaux IM pris en charge, définir /goal <condition de complétion> lance aussi une exécution avec la condition comme tâche ; les commandes de statut et de suppression ne gèrent que l'état du goal lui-même.
Sub-Agents
Les tâches complexes tiennent rarement en une seule passe. DeerFlow les décompose.
L'agent principal peut lancer des sub-agents à la volée — chacun avec son propre contexte délimité, ses outils et ses conditions d'arrêt. Les sub-agents s'exécutent en parallèle quand c'est possible, remontent des résultats structurés, et l'agent principal synthétise le tout en une sortie cohérente.
C'est comme ça que DeerFlow gère les tâches qui prennent de quelques minutes à plusieurs heures : une tâche de recherche peut se déployer en une dizaine de sub-agents, chacun explorant un angle différent, puis converger vers un seul rapport — ou un site web — ou un jeu de slides avec des visuels générés. Un seul harness, de nombreuses mains.
Sandbox et système de fichiers
DeerFlow ne se contente pas de parler de faire les choses. Il dispose de son propre ordinateur.
Chaque tâche s'exécute dans un conteneur Docker isolé avec un système de fichiers complet — skills, workspace, uploads, outputs. L'agent lit, écrit et édite des fichiers. Il exécute des commandes bash et du code. Il visualise des images. Le tout sandboxé, le tout auditable, zéro contamination entre les sessions.
C'est la différence entre un chatbot avec accès à des outils et un agent doté d'un véritable environnement d'exécution.
# Paths inside the sandbox container
/mnt/user-data/
├── uploads/          ← your files
├── workspace/        ← agents' working directory
└── outputs/          ← final deliverables
Context Engineering
Contexte isolé des Sub-Agents : chaque sub-agent s'exécute dans son propre contexte isolé. Il ne peut voir ni le contexte de l'agent principal, ni celui des autres sub-agents. L'objectif est de garantir que chaque sub-agent reste concentré sur sa tâche sans être parasité par des informations non pertinentes.
Résumé : au sein d'une session, DeerFlow gère le contexte de manière agressive — en résumant les sous-tâches terminées, en déchargeant les résultats intermédiaires vers le système de fichiers, en compressant ce qui n'est plus immédiatement pertinent. Ça lui permet de rester efficace sur des tâches longues et multi-étapes sans faire exploser la fenêtre de contexte.
Mémoire à long terme
La plupart des agents oublient tout dès qu'une conversation se termine. DeerFlow, lui, se souvient.
D'une session à l'autre, DeerFlow construit une mémoire persistante de votre profil, de vos préférences et de vos connaissances accumulées. Plus vous l'utilisez, mieux il vous connaît — votre style d'écriture, votre stack technique, vos workflows récurrents. La mémoire est stockée localement et reste sous votre contrôle.
Les mises à jour de la mémoire ignorent désormais les entrées de faits en double au moment de l'application, de sorte que les préférences et le contexte répétés ne s'accumulent plus indéfiniment entre les sessions.
Modèles recommandés
DeerFlow est agnostique en termes de modèle — il fonctionne avec n'importe quel LLM implémentant l'API compatible OpenAI. Cela dit, il offre de meilleures performances avec des modèles qui supportent :
- De longues fenêtres de contexte (100k+ tokens) pour la recherche approfondie et les tâches multi-étapes
- Des capacités de raisonnement pour la planification adaptative et la décomposition de tâches complexes
- Des entrées multimodales pour la compréhension d'images et de vidéos
- Un usage fiable des outils (tool use) pour des appels de fonctions et des sorties structurées fiables
Client Python intégré
DeerFlow peut être utilisé comme bibliothèque Python intégrée sans lancer l'ensemble des services HTTP. Le DeerFlowClient fournit un accès direct in-process à toutes les capacités d'agent et de Gateway, en retournant les mêmes schémas de réponse que l'API HTTP Gateway. Le HTTP Gateway expose également DELETE /api/threads/{thread_id} pour supprimer les données de thread locales gérées par DeerFlow après la suppression du thread LangGraph :
from deerflow.client import DeerFlowClient

client = DeerFlowClient()

# Chat
response = client.chat("Analyze this paper for me", thread_id="my-thread")

# Streaming (LangGraph SSE protocol: values, messages-tuple, end)
for event in client.stream("hello"):
    if event.type == "messages-tuple" and event.data.get("type") == "ai":
        print(event.data["content"])

# Configuration & management — returns Gateway-aligned dicts
models = client.list_models()        # {"models": [...]}
skills = client.list_skills()        # {"skills": [...]}
client.update_skill("web-search", enabled=True)
client.upload_files("thread-1", ["./report.pdf"])  # {"success": True, "files": [...]}
client.set_goal("thread-1", "finish the implementation and make all tests pass")
client.get_goal("thread-1")       # {"goal": {...}} or {"goal": None}
client.clear_goal("thread-1")
Toutes les méthodes retournant des dicts sont validées en CI contre les modèles de réponse Pydantic du Gateway (TestGatewayConformance), garantissant que le client intégré reste synchronisé avec les schémas de l'API HTTP. Voir backend/packages/harness/deerflow/client.py pour la documentation API complète.
Tâches planifiées (Scheduled Tasks)
DeerFlow inclut désormais un MVP de tâches planifiées (scheduled-task) de premier niveau dans le workspace.
Capacités actuelles du MVP :
- Gérer les tâches depuis
/workspace/scheduled-tasks - Choisir si chaque tâche planifiée réutilise un thread ou crée un nouveau thread à chaque exécution
- Prendre en charge les planifications
onceetcron - Exécuter les tâches planifiées en arrière-plan comme des exécutions DeerFlow non interactives (
ask_clarificationn'y est pas exposé) - Utiliser le comportement de chevauchement
skippour les exécutions cron dues qui entrent en collision avec une exécution active sur le même thread réutilisé - Mettre en pause, reprendre, déclencher, inspecter l'historique et supprimer les tâches
- Exécuter le travail planifié via le cycle de vie d'exécution normal de DeerFlow
Limites actuelles du MVP :
- Pas encore d'outil
schedule_taskcréable depuis la conversation - Pas de tâches de notification en texte seul
- Pas de cibles de dispatch canal ou GitHub
- Pas de type de planification
intervaldans cette première version
Activez le polling en arrière-plan avec config.yaml -> scheduler.enabled. Le déclenchement manuel utilise la même ressource scheduled-task et le même chemin d'exécution.
Atelier terminal (TUI)
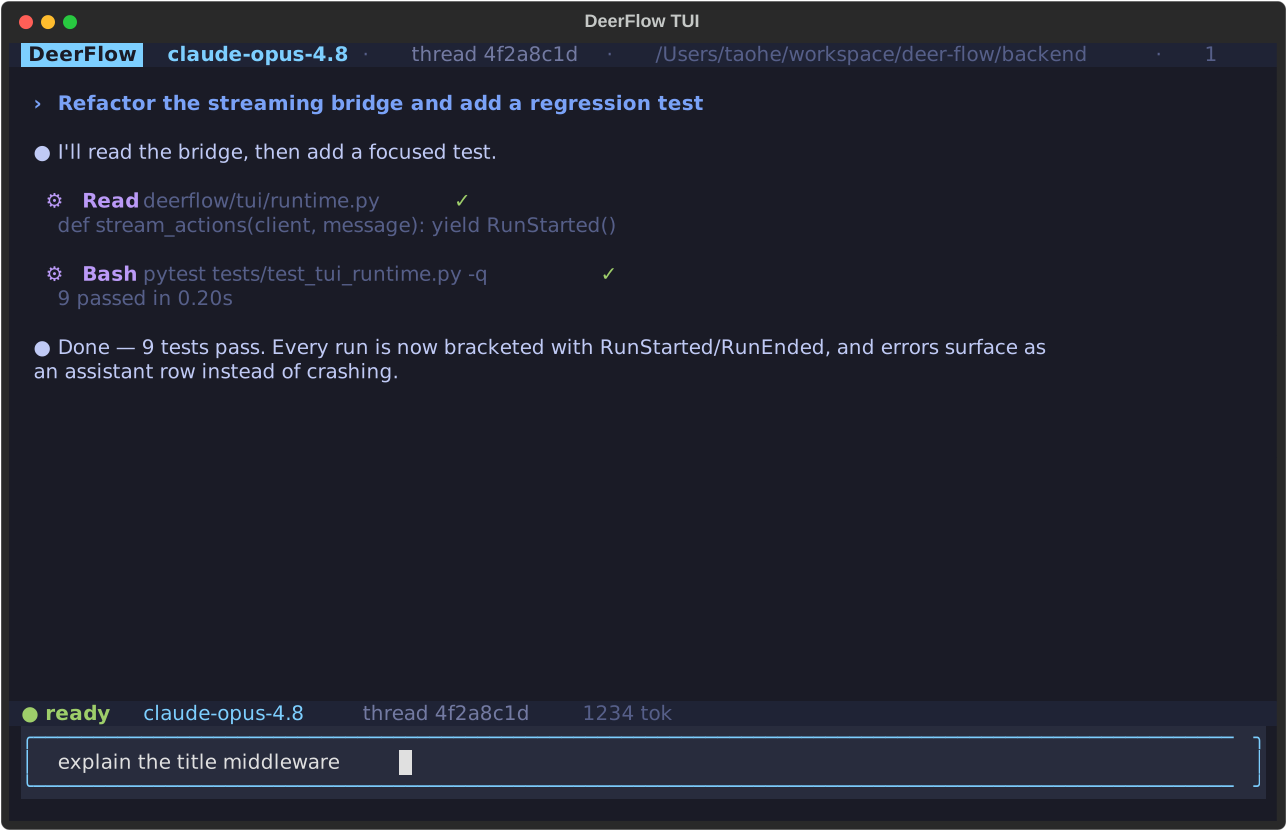
deerflow est un atelier natif terminal pour ceux qui vivent dans le shell. Il s'exécute de manière intégrée sur DeerFlowClient — pas besoin de Gateway, de frontend, de nginx ou de Docker — tout en honorant les mêmes config.yaml, checkpointer, skills, mémoire, MCP et sandbox que le reste de DeerFlow.
uv pip install 'deerflow-harness[tui]'        # dépendance optionnelle 'textual'

deerflow                                      # lancer l'UI terminal (TTY requis)
deerflow --continue                           # reprendre le thread le plus récent
deerflow --resume THREAD                      # reprendre un thread par id
deerflow --print "summarize this repo"        # réponse one-shot headless vers stdout
deerflow --json  "hello"                       # StreamEvents séparés par saut de ligne en mode headless
Une surface de chat pilotée au clavier avec un transcript en streaming (réponses rendues en Markdown), des cartes d'activité d'outils compactes, une palette de commandes slash /, la gestion des goal via /goal, des sélecteurs /model et /threads, l'historique de saisie, et l'interruption via Esc / Ctrl+C. Les sessions ouvertes dans le TUI apparaissent aussi dans la barre latérale du Web UI — elles écrivent dans le magasin de threads partagé sous l'utilisateur local par défaut, donc le terminal et le web restent synchronisés sans lancer la Gateway.
Voir backend/docs/TUI.md pour le guide complet.
Documentation
- Guide de contribution - Mise en place de l'environnement de développement et workflow
- Guide de configuration - Instructions d'installation et de configuration
- Vue d'ensemble de l'architecture - Détails de l'architecture technique
- Architecture backend - Architecture backend et référence API
⚠️ Avertissement de sécurité
Un déploiement inapproprié peut introduire des risques de sécurité
DeerFlow dispose de capacités clés à hauts privilèges, notamment l'exécution de commandes système, les opérations sur les ressources et l'invocation de logique métier. Il est conçu par défaut pour être déployé dans un environnement local de confiance (accessible uniquement via l'interface de loopback 127.0.0.1). Si vous déployez l'agent dans des environnements non fiables — tels que des réseaux LAN, des serveurs cloud publics ou d'autres environnements accessibles depuis plusieurs terminaux — sans mesures de sécurité strictes, cela peut introduire des risques, notamment :
- Invocation non autorisée : les fonctionnalités de l'agent pourraient être découvertes par des tiers non autorisés ou des scanners malveillants, déclenchant des requêtes non autorisées en masse qui exécutent des opérations à haut risque (commandes système, lecture/écriture de fichiers), pouvant causer de graves conséquences.
- Risques juridiques et de conformité : si l'agent est utilisé illégalement pour mener des cyberattaques, du vol de données ou d'autres activités illicites, cela peut entraîner des responsabilités juridiques et des risques de conformité.
Recommandations de sécurité
Note : nous recommandons fortement de déployer DeerFlow dans un environnement réseau local de confiance. Si vous avez besoin d'un déploiement multi-appareils ou multi-réseaux, vous devez mettre en place des mesures de sécurité strictes, par exemple :
- Liste blanche d'IP : utilisez
iptables, ou déployez des pare-feux matériels / commutateurs avec ACL, pour configurer des règles de liste blanche d'IP et refuser l'accès à toutes les autres adresses IP. - Passerelle d'authentification : configurez un proxy inverse (ex. nginx) et activez une authentification forte en amont, bloquant tout accès non authentifié.
- Isolation réseau : si possible, placez l'agent et les appareils de confiance dans le même VLAN dédié, isolé des autres équipements réseau.
- Restez informé : continuez à suivre les mises à jour de sécurité du projet DeerFlow.
Contribuer
Les contributions sont les bienvenues ! Consultez CONTRIBUTING.md pour la mise en place de l'environnement de développement, le workflow et les conventions.
La couverture de tests de régression inclut la détection du mode sandbox Docker et les tests de gestion du kubeconfig-path du provisioner dans backend/tests/.
Licence
Ce projet est open source et disponible sous la Licence MIT.
Remerciements
DeerFlow est construit sur le travail remarquable de la communauté open source. Nous sommes profondément reconnaissants envers tous les projets et contributeurs dont les efforts ont rendu DeerFlow possible. Nous nous tenons véritablement sur les épaules de géants.
Nous tenons à exprimer notre sincère gratitude aux projets suivants pour leurs contributions inestimables :
- LangChain : leur excellent framework propulse nos interactions LLM et nos chaînes, permettant une intégration et des fonctionnalités fluides.
- LangGraph : leur approche innovante de l'orchestration multi-agents a été déterminante pour les workflows sophistiqués de DeerFlow.
Ces projets illustrent le pouvoir transformateur de la collaboration open source, et nous sommes fiers de bâtir sur leurs fondations.
Contributeurs principaux
Un grand merci aux auteurs principaux de DeerFlow, dont la vision, la passion et le dévouement ont donné vie à ce projet :
Votre engagement sans faille et votre expertise sont le moteur du succès de DeerFlow. Nous sommes honorés de vous avoir à la barre de cette aventure.