mirror of
https://github.com/bytedance/deer-flow.git
synced 2026-10-27 13:40:37 +00:00
 35cdcab1c5
* feat(scheduler): lifecycle rules, goal/limit parity and coded errors for scheduled tasks

- Migration 0031: nullable scheduled_tasks.unmet_streak_after_seq (internal
  streak boundary) and stop_condition (the user's stop rule, own column).
- Stop rule is normalized (stop_rule.py) and appended only at launch; the
  stored prompt never contains it. Wording adapts when scheduler.tool_enabled
  is off.
- Willem 1: page-created tasks get goal evaluation, <standing_notes>, the
  previous-run reference and own-schedule stop; request_stop and the
  scheduled capability no longer require an origin conversation.
- Repository: single reactivation choke point raising
  ScheduledTaskLimitsExhausted; streak boundary moves on goal/prompt/stop
  condition/note changes (not on resume); goal-check failures neither count
  nor reset the streak; pause of a finished task returns "finished"; trials
  on a paused task keep the host pause marker.
- New repository reads: automatic_runs_used_for, active_run_status_for,
  list_manageable_from_thread, thread_relation/thread_run on thread tasks,
  task_ids_for_thread, run_number, and run_number/total_tokens/summary on
  run history rows.
- REST: goal/max_runs/end_at/stop_condition on create and PATCH (null
  clears, naive end_at = task timezone), resume recomputes from now with an
  optional renewal body, once_time_passed, task_finished, limits_exhausted,
  scheduler_not_running on create, trigger returns outcome/existing/thread_id,
  task responses add automatic_runs_used and active_run_status.
- Coded errors {code, message, params} for routes, shared validation and the
  chat capability (scheduled_task_errors.py), pinned by
  contracts/scheduled_task_errors_contract.json; goal notes contract v2 with
  check_failure_codes, scheduled_origin_key and host_run_errors (host_notes.py).
- /api/features adds scheduled_tasks {available, running, tool_enabled,
  min_interval_seconds}; ScheduledTaskService.is_running.
- Docs: six README scheduler sections, API.md scheduled tasks section
  (breaking error shape), CONFIGURATION.md, AGENTS notes, CHANGELOGs.
- Tests: migration 0031, stop rule, error contract, run listing, lifecycle
  over HTTP, repository, service and capability cases; updated tests for the
  new error shape, finished-task pause and head revision.

* feat(scheduler): conversation update/resume, run-conversation authority and readable launches

- schedule_task: update and resume actions, stop_condition and clear_fields
  parameters, plain parameter types (value rules come back as coded results),
  rewritten docstrings for schedule_task and stop_scheduled_task.
- Capability: update/resume share the REST validation and error codes;
  interactive turns in a task's run conversation may manage that task;
  scheduled runs keep only own-stop; grants require a running scheduler.
- Results: compact JSON-safe task views with local times, display card/text,
  last run in list, timezone_source/browser_timezone, now_local; no ISO, user,
  lease or origin fields; stop_instructions removed.
- Timezone: explicit > browser (context.client_timezone, validated in
  start_run and never forwarded to the run config) > not needed for intervals
  and offset run_at > timezone_required.
- Trial gate accepts natural direct requests after acknowledgements and
  particles; trial results report thread_id and existing.
- Scheduled launches: stable message id scheduled-<task_run_id>, server-owned
  deerflow_scheduled_origin metadata with the user-language parts, run thread
  title for fresh-thread tasks.
- Worker records goal continuations in the verdict; lead prompt language rule
  covers stored task text and scheduled runs.
- Docs: six READMEs, CONFIGURATION, API, runtime/tools AGENTS, CHANGELOGs.

* feat(frontend): scheduled-task core types, formatting, errors and glossary

- throwGatewayApiError now throws GatewayApiError (status, code, params,
  rawMessage); message stays the string detail or detail.message
- scheduled-task types gain stop_condition, automatic_runs_used,
  active_run_status, origin/notes, run_number/total_tokens/summary, thread
  relation, trigger result, renewal and scheduled origin; isTaskBusy and
  hasActiveRun helpers
- api: fetchScheduledTask, resume with optional renewal body, typed trigger
  result and update payload with null clears
- hooks: polling at 3 s while a run is active (list, thread list, run
  history), useScheduledTask with live gating and final 404, useInView,
  localized error toasts; run history refreshes tasks when a run finishes
- new pure modules: errors.ts (contract code to localized copy), format.ts
  (relative task times, viewer time, display zone), status.ts, actions.ts,
  run-error.ts; describeTaskSchedule in cron.ts; goal-outcome adds unchecked
  goal checks, describeTaskOutcome and parseStopRunId
- features: scheduled_tasks block with defaults when missing
- buildRunContext sends client_timezone
- titleOfThread takes a localized untitled label; breadcrumb names scheduled
  tasks and agents; reference chips use the localized untitled label
- schedule input: shared browserTimeZone, labelled selects, aria-pressed
  type toggles, interval minimum from the hint template
- i18n: all PR1 scheduled-task keys in en-US and zh-CN, glossary fixes,
  recipe instructions moved into i18n
- e2e mocks follow the new task, trigger, resume, thread-task and features
  shapes; expectNoRawIdentifiers helpers for e2e and DOM tests
- tests for errors, format, cron, status, actions, goal outcome, run errors,
  hooks, run context, thread titles and features; scheduled e2e copy updated

* feat(frontend): list-first scheduled tasks page with outcomes and editable goals

- page.tsx is now a thin composition of components/workspace/scheduled-tasks:
  status tabs (All/Active/Paused/Finished) and search over the task list,
  ?task_id= deep link with router.replace on selection, ?thread_id= chip
  with Show all, empty state, scheduler-off notice and unavailable state
- task list rows show the schedule in words and one status line (next run,
  running now, paused by agent, auto-paused, finished by its cap)
- task detail: status badge, actions from availableActions with reasons,
  More actions menu (Duplicate, Copy task ID, Delete), outcome notice,
  Runs / Stops when / Each run's goal / Does / Notes from chat / History,
  origin chat link; success toasts for every action
- run rows: run number or Trial run, summary, goal and assumption badges,
  continuations, tokens, Open chat link; raw errors and the evaluator
  reason only behind Details
- create/edit/duplicate dialog with goal, stop condition, safety caps and
  advanced agent/context options; PATCH sends only changed fields, null
  clears a cap
- renew dialog raises or removes caps and resumes in one request; a
  limits_exhausted Resume opens it
- removed i18n keys the old page used; added feedback.resumedNoTime
- recorded en-3 and zh-1 page fixtures; scheduled e2e specs rewritten for
  the new page; DOM tests for the detail and the form dialog
- CHANGELOG entries and the frontend AGENTS.md scheduled-task note

* feat(frontend): live schedule card, run conversation provenance and header entry

- schedule_task results (create, update, pause, resume, trial, delete) become
  an assistant:scheduled-task message group rendered as a live card: schedule,
  next run, stop condition with the safety cap, goal, where results go, Run
  once now, Pause/Resume and Open task; the card polls the task only while it
  is on screen and shows deleted, scheduler-off and limits-exhausted states
- one card per task per assistant turn; the card group is not a turn boundary
  for usage, branching, editing, outline or skill attribution
- a human message with deerflow_scheduled_origin stays a human group with
  scheduledOrigin and renders as a "Scheduled run / Trial run" block with the
  task instructions, stop condition and notes collapsed; the launched text is
  never shown and the message is not editable
- readable step labels for schedule_task actions and stop_scheduled_task
- ThreadScheduledTasksButton replaces the header link: hidden without tasks,
  shows the count, links to the task (or the chat filter), and a run's chat
  links to its task
- recorded en-3 / zh-1 chat and run-thread fixtures; chat-card and run-thread
  e2e specs; unit and DOM tests for parsing, grouping, turn boundaries, card,
  run block, header button, step labels and reconnect hydration
- i18n: header.countLabelOne added, unused card.next removed; CHANGELOG and
  frontend AGENTS.md notes

* fix(scheduler): address verification findings

Move the scheduled-task lifecycle guidance from backend/AGENTS.md into the persistence guide and leave a one-line pointer, so the effective AGENTS.md chains for agents/middlewares, sandbox and subagents stay under the 98304-byte hard limit enforced by scripts/check_agent_guidance.py in lint-check.

* fix(scheduler): address review findings

* fix(gateway): no-transform on SSE responses

All four text/event-stream responses (thread run create stream, join,
existing-run GET/POST stream, stateless create stream) now take their
headers from app/gateway/sse_headers.py and send
Cache-Control: no-cache, no-transform, so compressing proxies such as
Next's rewrite proxy stop buffering streams. Content-Location and
X-Accel-Buffering are unchanged; scheduled and MCP-notification runs keep
stream_mode=None.

Tests pin the headers on every SSE route and fail on a literal no-cache
header left in routers. Docs: API.md SSE headers note, CHANGELOGs.

* feat(scheduler): per-owner run cap and fair queue selection

New scheduler.max_concurrent_runs_per_user (default 2, 0 = off, effective
min(cap, max_concurrent_runs)) caps launching/running scheduled runs per task
owner. claim_queued_run checks it right after the global count under the same
budget lock, so it is atomic across workers and Pods. list_queued_runs ranks
same-thread FIFO heads per owner with ROW_NUMBER() OVER (PARTITION BY owner)
and orders the batch by that rank, so the drain is owner-fair even with the
cap off; owners at their cap drop out before the batch limit. Orphan rows
(task deleted while queued) are never held back by the cap.

Gateway lifespan passes the startup value; the service constructor default
stays 0. Docs: config.example.yaml (config_version 54), CONFIGURATION.md,
the six READMEs, backend AGENTS.md, CHANGELOGs (behavior change flagged).
The live-task quota is untouched.

* feat(scheduler): durable lifecycle events for the originating chat

When a chat-created schedule is paused by the agent, auto-paused or finishes,
finalization now reports task_stopped / task_paused / task_finished, only on a
live -> paused/finished transition. The new finish_task_at_end_condition
replaces the three inline "mark completed" blocks (admission rejected as ended,
claim-time skip, complete_if_ended), so every site emits exactly once.

The scheduler's finalization observer is always installed. It writes
scheduled_task_events rows for the originating chat in the same transaction as
the state change, deduplicated on (task_id, anchor, event), with a title
snapshot, stop condition, run number, last run outcome and the chat's newest
run as placement anchor. Lookups fall back on bad stored data; only database
errors propagate. Manual trials drop only run_* events. The IM step keeps
PR1's selection until B4.

New GET /api/threads/{thread_id}/scheduled-task-events (owner check, caller's
rows, oldest first); rows survive task deletion and go with the chat.
Migration 0032_activity_and_task_events adds the events table plus the
run-origin column/index and read-state tables used later, each object guarded
on its own. Contract scheduled_goal_notes v3 pins the lifecycle vocabulary.
Docs: API.md, migrations chain, backend AGENTS.md, six READMEs, CHANGELOGs.

* feat(scheduler): honest, localized and self-contained IM notices

Every scheduled-task IM notice is now enqueued by the finalization observer
in the transaction that records the outcome, one message per occurrence
(task_stopped > task_paused > task_finished > run_failed > run_unmet >
run_completed; a once task sends only its run event). The merged auto-pause
replaces the separate unmet + pause messages, agent stops and finishes now
notify, and recovery-finalized runs notify exactly once. Idle finishes use a
deterministic idle: key derived from the lifecycle anchor. The old
non-transactional enqueue in handle_run_completion is removed.

New app/channels/capabilities.py holds CHANNEL_CAPABILITIES with a
proactive_notifications flag (adds the missing qq entry); only push-capable
providers (WeCom) get rows, /api/channels/providers returns the flag, and the
worker ends legacy rows for other providers as terminal failed.

New app/scheduler/notification_text.py renders en-US/zh-CN text: title, what
happened (plus the last run's outcome), the tasks page's one-line run summary
(redacted) when the agent replied, and a closing line. No IDs, no links, no
public_base_url. Locale is the owner's new `locale` preference, else the new
channel_connections.notification_locale (default en-US).

Docs: config.example.yaml (config_version 55), CONFIGURATION.md, API.md,
channels AGENTS.md, six READMEs, CHANGELOGs (behavior change flagged).

* feat(gateway): thread origin, activity feed and read markers for server-created threads

Runs started by the server for a user (scheduler, IM channels, GitHub
agents, extension handles, MCP notifications) now carry a server-owned
metadata.deerflow_origin {kind, provider?, namespace?} (new harness module
deerflow.runtime.run_origin, pinned by contracts/thread_origin_contract.json).
It is stamped only from request.state.run_origin or by the internal channel
caller; run admission drops client copies from both metadata and
config.metadata, and thread create/patch strip it. RunRepository derives
runs.origin_kind on put and on create_thread_operation_atomic (agent runs
only), and gains latest_change().

New ThreadReadRepository keeps a per-user, never-decreasing read position
(thread_read_markers) and a per-user read clock (thread_read_versions).
POST /api/threads/{id}/read marks a thread read, thread search items carry
unread, and thread delete removes the markers. GET /api/thread-activity pages
the caller's run changes over the run-change clock, returns only threads
changed by server-originated runs plus read_version, and 503s without SQL;
/api/features reports thread_activity.available.

Docs: API.md, gateway AGENTS.md (condensed to stay under its budget),
CHANGELOGs.

* fix(scheduler): adapt PR2 to PR1 follow-ups

PR1 moved the scheduled-task lifecycle rules out of backend/AGENTS.md into
the persistence guide and grew the sandbox AGENTS.md chain to within 267
bytes of its hard limit. The per-owner queue-fairness detail now lives in
the persistence guide next to the lifecycle rules (backend/AGENTS.md keeps
the cap and a link), so check_agent_guidance passes again.

PR1's goal-outcome unit test pinned scheduled_goal_notes_contract version 2;
PR2 bumps it to 3 (lifecycle vocabulary only, the v2 keys are unchanged).

* fix(scheduled-tasks): polish from live acceptance

- zh schedule wording: an interval of one unit reads 每分钟 / 每小时 / 每秒,
  and a saved interval of whole days reads 每天 / 每 2 天 (Every day / Every 2
  days) instead of 每 1 分钟 or 每 24 小时; several units keep the number
- zh spacing: 已于{time} 满足 and 在{time} 的运行中 now leave a space between
  the interpolated time and the Chinese after it; a copy test guards every
  scheduled-task zh string against a placeholder glued to Chinese
- run summary: when the first line of the final reply only leads in to a list
  (ends with ":" or ":"), the list items follow it as plain text (bullets,
  numbering, checkboxes, bold, code and links stripped), joined with ";" for
  CJK text and "; " otherwise, within the 160-character cap
- a schedule_task result (create, update, pause, resume, trial, delete) that
  arrives in a chat invalidates that chat's task list, the tasks list and the
  named task, so the header button and cards update without waiting for the
  idle poll; results already in the loaded history do not refetch
- e2e and unit fixtures are now the live acceptance recordings (DeepSeek
  Flash, demo data, fictional names): live-weekday.json (create, trial, edit,
  pause, resume in one zh chat) and live-minute.json (per-minute chat, run 1
  and run 2, paused by the agent), fetched with GET from the demo Gateway and
  trimmed; the hand-shaped en-3 / zh-1 fixtures are removed and the chat-card,
  run-thread and tasks-page specs run in both locales over the recorded data

* docs(changelog): reference #6378 for the scheduled-tasks entries

* docs(agents): shorten the scheduled-task pointer to stay under the guidance limit

* test(scheduled-tasks): pin the live takes to their recorded time zone

The live fixtures were recorded in Asia/Shanghai, and an interval task
reads in the viewer's zone, so the 16:48 assertions failed on UTC CI
runners. Pin the browser zone in the two live-take e2e specs and the
zh live-take unit test.

* feat(frontend): thread origin, activity polling, read markers and task events core

Frontend core for server-created threads and schedule lifecycle events
(PR2 F1); the sidebar markers (F2) and the chat event line (F3) build on it.

- core/threads/origin.ts: threadOriginOf reads metadata.deerflow_origin,
  then channel_source (github -> GitHub origin), then a legacy
  scheduled_task_id; key and kinds pinned to
  contracts/thread_origin_contract.json. labelOfThreadOrigin and the now
  exported labelOfChannelProvider(provider, t) use the new localized
  threads.origin.providers names (飞书, 企业微信, ...), with the English map
  (gaining GitHub) only as the fallback.
- core/threads/activity.ts: useThreadActivity polls /api/thread-activity
  every 15 s (focus refetch, never in the background, off unless
  features.thread_activity.available). The first response only seeds the
  cursor; server-origin threads, a truncated page or a higher read_version
  invalidate the thread lists, a scheduled thread also ["scheduled-tasks"];
  an invalid cursor re-seeds. useMarkThreadRead debounces POST /read by 1 s,
  skips a thread whose cached unread is false, patches the search and
  infinite caches optimistically and stores the returned read_version so a
  tab's own read does not refetch its lists. AgentThread gains unread.
- core/scheduled-tasks/events.ts: ScheduledTaskEvent, the events query
  (["scheduled-tasks","thread-events",id], one fetch per saved chat, not
  gated on the task list so a deleted task's lines stay, refetched when a
  task of the chat changes status or finishes a run), describeTaskEvent
  (en/zh copy, title and condition as segments, last-run suffix, See that
  run / Open task) and placeTaskEvents (end of the after_run_id turn, else
  the tail, ordered by created_at); lifecycle names pinned to contract v3.
- features: thread_activity (default unavailable); channels:
  proactive_notifications on providers.
- Locale sync: the I18nProvider reports the UI language and a signed-in
  preference session saves it as the new `locale` preference when the
  account's differs (and on every switch), so IM notices follow the UI
  language; nothing is written with auth disabled.
- i18n: threads.* (unread, origin labels, provider names),
  scheduledTasks.events.*, history.waitingForSlot (now shown for queued run
  rows), channels.scheduledUpdates.*.
- e2e mocks: thread activity feed and controller, POST /read, the events
  route, providers with proactive_notifications, search unread, features
  thread_activity (off by default). Preference e2e mocks return the UI
  locale so they keep asserting only their own edits.
- Docs: frontend AGENTS.md, CHANGELOGs.

* fix(scheduled-tasks): keep untouched end times and drop a chat filter the new task is not in

- The edit, duplicate and renew dialogs keep a stored end time's instant
  while its field still shows it. A minute-precision wall value cannot
  keep seconds or name the later 01:30 of a DST fall-back, so a
  title-only edit moved the cap an hour earlier, and raising the run
  limit re-sent the end time without its seconds.
- Creating or duplicating a task from a chat's task view drops the chat
  filter when the new task does not belong to that chat, instead of
  showing "This task isn't one of this chat's tasks".

* feat(frontend): origin markers and unread state in the thread lists

Server-created threads (PR2 F2) now say who created them and whether they
are new, in the sidebar and on the Chats page, and reach an open sidebar
without a reload.

- ThreadOriginIcon (thread-channel-source.tsx): clock for a scheduled run,
  the provider mark for IM threads, the GitHub mark (new in
  ChannelProviderIcon) for GitHub threads, a puzzle piece for extensions;
  the localized "Scheduled run" / "From Feishu" / "From GitHub" / "From an
  extension" label is its accessible name and tooltip. ThreadChannelIcon
  stays exported as a wrapper, and the provider chip tooltip is localized
  (no more "Feishu channel").
- Unread dot after the title (aria-hidden dot plus sr-only "Unread"); the
  row aria-label becomes "{title}, unread" / "{title},未读". Never shown for
  the open thread.
- WorkspaceSidebar mounts useThreadActivity once.
- useMarkOpenThreadRead (components/workspace/chats): the default and
  custom-agent chat pages mark the thread read once its metadata has
  loaded, when its cached unread flips to true while open, when the tab
  becomes visible, and from onFinish (a send or a joined run ended). Each
  trigger goes through useMarkThreadRead, so it is debounced and a no-op
  while the cached unread is false.
- Tests: thread-origin-icon and recent-chat-list DOM tests (en/zh, active
  row, no raw identifiers), use-mark-open-thread-read DOM tests,
  e2e thread-activity.spec.ts (new scheduled run appears unread within one
  fake-clock poll without a reload, opening it posts /read and clears the
  dot, a read on another device clears it, IM and GitHub markers, zh
  labels, the Chats page, no polling when unavailable);
  thread-history.spec.ts now finds the localized origin icon.
- Docs: frontend AGENTS.md, CHANGELOGs.

* feat(frontend): schedule event line in the originating chat and channel notice support

The chat that created a schedule now says when the schedule paused or
ended, and the channel cards say which apps receive scheduled task updates
(PR2 F3).

- ScheduledTaskEventLine (mockup m2, marker 4): a dashed, muted row with
  the describeTaskEvent text (title in <strong>, stop condition clamped to
  one line with the full text in its tooltip, last-run suffix), the time
  via formatTaskTime and a right-aligned "See that run" (run chat) or
  "Open task" link. PauseCircle for paused, CircleCheck for finished and
  once-done, CircleX for once-failed. role="note", aria-label "Scheduled
  task update" / "定时任务通知", data-task-id and data-event-id only.
- MessageList takes scheduledTaskEvents and renders placeTaskEvents output
  through a new VirtualMessageList.renderAfterGroup, so each line sits at
  the end of its after_run_id turn inside the group's measured row (also
  when the list virtualizes); lines with nowhere to go render at the tail.
- Both chat pages load useThreadScheduledTaskEvents (not gated on the task
  list, so the lines stay after a task is deleted). The custom-agent page
  passes its agent so "See that run" opens the run on that agent's route.
- ChannelScheduledUpdates: "Scheduled task updates: sent here" / "... not
  available for this app yet" (定时任务通知:会发送到这里 / 此应用暂不支持)
  on the Settings provider cards and under each sidebar channel row; nothing
  when an older backend does not report proactive_notifications.
- e2e mock controller: setScheduledTasks.
- Tests: scheduled-task-event-line and channel-scheduled-updates DOM tests
  (every kind in en and zh, hrefs, clamp, no raw identifiers, Chinese
  title), MessageList placement DOM tests; e2e
  scheduled-task-chat-events.spec.ts (the line appears with the card's
  "Paused by agent" without a reload, See that run opens the run chat,
  anchored vs tail placement, two events in time order, the line survives
  task deletion and Open task shows the task is gone; en-3 and zh-1) and
  channels.spec.ts (WeCom sent here, Feishu not yet; en and zh).
- Docs: frontend AGENTS.md, CHANGELOGs.

* fix(scheduled-tasks): tie pause notices to the pause they describe

- Paused by agent links and times only the run named in last_error. When
  that run is not loaded, the notice shows no link and the task's own time
  instead of an earlier run that also asked to stop.
- The outcome notice reads the latest history page whichever page is
  shown, so browsing older runs no longer swaps the auto-pause reason and
  "Open latest run" to an earlier miss. It shares that page's request.

* fix(scheduler): address PR2 review findings

- Event lines: hold an event whose anchor run is on an unloaded history
  page instead of placing it at the bottom (hasMoreHistory); tail fallback
  only for fully loaded (branched/pruned) history or no anchor.
- Idle-finish anchor follows its reason: end:<iso> only for an end_at
  finish, seq:<n> otherwise, so a later end-time finish is not deduplicated
  away by an earlier max_runs finish.
- Observer takes FOR SHARE on the originating threads_meta row, so a racing
  thread delete cannot leave an orphan event line.
- One taskPagePath (core), re-exported by the card.
- Notification locales derived from NotificationLocale; /preferences uses it.
- IM notices drop generic reasons (goal_not_met_yet, unknown) instead of
  repeating the sentence.
- Localized provider names on Settings cards, sidebar rows and setup dialog.
- zh event lines: no space after a Chinese title (Latin-aware gap).
- Unread row label keeps the origin marker; chats page keeps the time as a
  description.
- Sidebar shows the scheduled-updates line only for connected apps;
  Settings says "available after you connect" for unconnected push apps.
- Event line keeps a real space before the time.

* fix(scheduled-tasks): three lifecycle gaps found while re-checking review classes

- The edit form compares a cron in the form its schedule input emits, so an
  untouched "0 09 * * 0,6" is not re-sent as "0 9 * * 6,0" and a title-only
  edit no longer re-arms or refuses a finished task.
- Chat resume asks for a timezone, as update does, when a naive end_at would
  land in the UTC placeholder of a zone-free task.
- Re-arming a task clears a host pause marker, as resume does, so a later
  manual pause no longer reads as "Paused by agent".

* test(scheduler): consolidate PR2 backend test setup

- Fold the repeated task, origin-chat and observer setup of the
  lifecycle-event repository tests into one lifecycle_task builder.
- Build the per-owner-cap services through one _capped_service builder
  that keeps every cap explicit at the call site.
- Table the five SSE route header checks into one parametrized test with
  the same routes, bodies and Content-Location expectations.
- Reuse bind_wecom and hoist repeated local imports in the event tests.

Every case and assertion is kept; collected cases are unchanged.

* test(frontend): consolidate PR2 thread activity and origin test setup

Extract shared builders and helpers in the frontend tests PR2 adds, with
every case, input and assertion kept:

- activity.test.ts: seededClient/apply helpers and one LIST_KEYS constant
  replace the per-test seed, spy and apply boilerplate.
- mark-read.dom.test.tsx: newClient() and advance() replace the repeated
  QueryClient wrapper and fake-timer act blocks.
- origin.test.ts: the English and Chinese label checks become tables; the
  no-English-name check now runs on every Chinese row.
- thread-activity.spec.ts: a scheduledRun() builder replaces four inline
  copies of the scheduled run thread.
- channels.spec.ts: the PR2 block uses setLocaleCookie and one card helper.

Collected cases are unchanged (unit 211, e2e 60); no test was removed.

* fix(scheduled-tasks): keep the notice's latest-runs query from refreshing older pages

useLatestScheduledTaskRuns kept React Query's default refetch on mount,
focus and reconnect, so going offline and back while an older history page
was shown fetched the latest page again. Refreshing stays with the history,
which refreshes the latest page only while it is shown.

* fix(scheduler): two gaps found in live acceptance

- A fresh scheduled run thread is named when it launches. The worker
  copied the title to the thread list only when the run ended, so the
  sidebar, which now shows the new run thread at once, listed it as
  untitled while it ran.
- A task capped at one run finishes with "its one run is done" /
  "唯一一次运行已完成" in the chat event line and the IM notice, instead
  of "all 1 runs are done".

* test(scheduled-tasks): let the viewer's time carry its own day label

Between 16:00 and 24:00 UTC, UTC and Asia/Shanghai are on different days,
so the run prompt shows "Tomorrow 01:00 · Today 09:00 your time" and the
fixed "01:00 · 09:00 your time" assertion failed depending on the hour.

* test(scheduler): expect the one-run finish copy in service notices

* fix(gateway): create a scheduled run thread with its title

Pre-setting the name after start_run raced the thread row, which the run
worker creates asynchronously: live, one of two run threads still reached
the sidebar untitled. Run admission now creates a new thread with the title
its run input carries, which the worker would copy only at run end.

* docs(changelog): reference #6393 for the scheduled-task signal entries

* fix(scheduled-tasks): route event-line run links by the agent that ran them

The originating chat's agent was used for "See that run", but a task's
agent can change after the chat created it, so the link could open the run
chat on another agent's route. Lifecycle events now record run_agent_name,
the task's agent when the run finished (edits are refused while a run is
active), and the line routes by it.

* fix(scheduled-tasks): load up to the route's maximum of chat event lines

The chat loads its lifecycle events once, and the route's default of 50
would silently drop the oldest lines of a chat with many schedules. Ask
for the maximum, 200.

* fix(threads): keep activity reads and the first cursor in step with the lists

- Accepting the first activity cursor refreshes the thread lists once. The
  lists load on their own, possibly before a run the seed already counts,
  and later polls start after it, so such a thread never appeared.
- A local read whose returned read clock jumps past that one read also
  covers reads on other devices; the lists are refreshed instead of the
  clock silently skipping those threads' stale unread dots.
- An invalid cursor re-seeds through the same path, so it refreshes once.

* docs(agents): bring the middlewares guidance chain back under the hard limit

#6378 and #6363 each fit the budget, but together the middlewares AGENTS.md
chain on main is 98,425 bytes, 121 over the 98,304 hard limit, so Lint
Check fails on main. Move the scheduled-task recovery, launch-update and
queue-timeout rules from backend/AGENTS.md into the persistence guide's
lifecycle section, which backend/AGENTS.md already points to. The chain is
now 98,067 bytes.

* fix(helm): bump the chart's config_version to 55

config.example.yaml moved to 55 in this PR, so the Helm chart's
validate-chart drift check failed. The chart's embedded config needs no
field changes: the new scheduler and channel keys have defaults.

---------

Co-authored-by: Totoro-qaq <279883115+Totoro-qaq@users.noreply.github.com>
Co-authored-by: Willem Jiang <willem.jiang@gmail.com>
837 lines
59 KiB
Markdown
837 lines
59 KiB
Markdown
# 🦌 DeerFlow - 2.0
|
||
|
||
[English](./README.md) | [中文](./README_zh.md) | [日本語](./README_ja.md) | Français | [Русский](./README_ru.md) | [Português](./README_pt.md)
|
||
|
||
[](./backend/pyproject.toml)
|
||
[](./Makefile)
|
||
[](./LICENSE)
|
||
|
||
<a href="https://trendshift.io/repositories/14699" target="_blank"><img src="https://trendshift.io/api/badge/repositories/14699" alt="bytedance%2Fdeer-flow | Trendshift" style="width: 250px; height: 55px;" width="250" height="55"/></a>
|
||
> Le 28 février 2026, DeerFlow a décroché la 🏆 1re place sur GitHub Trending suite au lancement de la version 2. Un immense merci à notre incroyable communauté — c'est grâce à vous ! 💪🔥
|
||
|
||
DeerFlow (**D**eep **E**xploration and **E**fficient **R**esearch **Flow**) est un **super agent harness** open source qui orchestre des **sub-agents**, de la **mémoire** et des **sandboxes** pour accomplir pratiquement n'importe quelle tâche — le tout propulsé par des **skills extensibles**.
|
||
|
||
https://github.com/user-attachments/assets/a8bcadc4-e040-4cf2-8fda-dd768b999c18
|
||
|
||
> [!NOTE]
|
||
> **DeerFlow 2.0 est une réécriture complète.** Il ne partage aucun code avec la v1. Si vous cherchez le framework Deep Research original, il est maintenu sur la [branche `1.x`](https://github.com/bytedance/deer-flow/tree/main-1.x) — les contributions y sont toujours les bienvenues. Le développement actif a migré vers la 2.0.
|
||
|
||
## Site officiel
|
||
|
||
Découvrez-en plus et regardez des **démos réelles** sur notre [**site officiel**](https://deerflow.tech).
|
||
|
||
## Projets associés
|
||
|
||
<img width="446" height="280" alt="image" align="middle" src="https://github.com/user-attachments/assets/077edef4-d560-41af-bb0d-d0a5f14fcc20" />
|
||
|
||
- [**LLM Space**](https://github.com/deer-flow/llm-space) - Découvrez notre arme secrète derrière DeerFlow — un outil de bureau pour prototyper des idées d'agents, inspecter chaque étape du harness, rejouer les échecs et tester les performances.
|
||
|
||
## Coding Plan de ByteDance Volcengine
|
||
|
||
- Nous recommandons fortement d'utiliser Doubao-Seed-2.0-Code, DeepSeek v3.2 et Kimi 2.5 pour exécuter DeerFlow
|
||
- [En savoir plus](https://www.byteplus.com/en/activity/codingplan?utm_campaign=deer_flow&utm_content=deer_flow&utm_medium=devrel&utm_source=OWO&utm_term=deer_flow)
|
||
- [Développeurs en Chine continentale, cliquez ici](https://www.volcengine.com/activity/codingplan?utm_campaign=deer_flow&utm_content=deer_flow&utm_medium=devrel&utm_source=OWO&utm_term=deer_flow)
|
||
|
||
## InfoQuest
|
||
|
||
DeerFlow intègre désormais le toolkit de recherche et de crawling intelligent développé par BytePlus — [InfoQuest (essai gratuit en ligne)](https://docs.byteplus.com/en/docs/InfoQuest/What_is_Info_Quest)
|
||
|
||
<a href="https://docs.byteplus.com/en/docs/InfoQuest/What_is_Info_Quest" target="_blank">
|
||
<img
|
||
src="https://sf16-sg.tiktokcdn.com/obj/eden-sg/hubseh7bsbps/20251208-160108.png" alt="InfoQuest_banner"
|
||
/>
|
||
</a>
|
||
|
||
---
|
||
|
||
## Table des matières
|
||
|
||
- [🦌 DeerFlow - 2.0](#-deerflow---20)
|
||
- [Site officiel](#site-officiel)
|
||
- [Coding Plan de ByteDance Volcengine](#coding-plan-de-bytedance-volcengine)
|
||
- [InfoQuest](#infoquest)
|
||
- [Table des matières](#table-des-matières)
|
||
- [Installation en une phrase pour un coding agent](#installation-en-une-phrase-pour-un-coding-agent)
|
||
- [Démarrage rapide](#démarrage-rapide)
|
||
- [Configuration](#configuration)
|
||
- [Lancer l'application](#lancer-lapplication)
|
||
- [Option 1 : Docker (recommandé)](#option-1--docker-recommandé)
|
||
- [Option 2 : Développement local](#option-2--développement-local)
|
||
- [Avancé](#avancé)
|
||
- [Mode Sandbox](#mode-sandbox)
|
||
- [Serveur MCP](#serveur-mcp)
|
||
- [Canaux de messagerie](#canaux-de-messagerie)
|
||
- [Traçage LangSmith](#traçage-langsmith)
|
||
- [Traçage Langfuse](#traçage-langfuse)
|
||
- [Utiliser les deux fournisseurs](#utiliser-les-deux-fournisseurs)
|
||
- [Du Deep Research au Super Agent Harness](#du-deep-research-au-super-agent-harness)
|
||
- [Fonctionnalités principales](#fonctionnalités-principales)
|
||
- [Skills et outils](#skills-et-outils)
|
||
- [Intégration Claude Code](#intégration-claude-code)
|
||
- [Objectifs de session (Session Goals)](#objectifs-de-session-session-goals)
|
||
- [Sub-Agents](#sub-agents)
|
||
- [Sandbox et système de fichiers](#sandbox-et-système-de-fichiers)
|
||
- [Context Engineering](#context-engineering)
|
||
- [Mémoire à long terme](#mémoire-à-long-terme)
|
||
- [Modèles recommandés](#modèles-recommandés)
|
||
- [Client Python intégré](#client-python-intégré)
|
||
- [Projets](#projets)
|
||
- [Tâches planifiées (Scheduled Tasks)](#tâches-planifiées-scheduled-tasks)
|
||
- [Atelier terminal (TUI)](#atelier-terminal-tui)
|
||
- [Documentation](#documentation)
|
||
- [⚠️ Avertissement de sécurité](#️-avertissement-de-sécurité)
|
||
- [Contribuer](#contribuer)
|
||
- [Licence](#licence)
|
||
- [Remerciements](#remerciements)
|
||
- [Contributeurs principaux](#contributeurs-principaux)
|
||
- [Star History](#star-history)
|
||
|
||
## Installation en une phrase pour un coding agent
|
||
|
||
Si vous utilisez Claude Code, Codex, Cursor, Windsurf ou un autre coding agent, vous pouvez simplement lui envoyer cette phrase :
|
||
|
||
```text
|
||
Aide-moi à cloner DeerFlow si nécessaire, puis à initialiser son environnement de développement local en suivant https://raw.githubusercontent.com/bytedance/deer-flow/main/Install.md
|
||
```
|
||
|
||
Ce prompt est destiné aux coding agents. Il leur demande de cloner le dépôt si nécessaire, de privilégier Docker quand il est disponible, puis de s'arrêter avec la commande exacte pour lancer DeerFlow et la liste des configurations encore manquantes.
|
||
|
||
## Démarrage rapide
|
||
|
||
### Configuration
|
||
|
||
1. **Cloner le dépôt DeerFlow**
|
||
|
||
```bash
|
||
git clone https://github.com/bytedance/deer-flow.git
|
||
cd deer-flow
|
||
```
|
||
|
||
2. **Lancer l'assistant de configuration (recommandé)**
|
||
|
||
Depuis le répertoire racine du projet (`deer-flow/`), exécutez :
|
||
|
||
```bash
|
||
make setup
|
||
```
|
||
|
||
Cette commande lance un assistant interactif qui vous guide dans le choix d'un fournisseur LLM, d'une recherche web optionnelle et des préférences d'exécution/sécurité (mode sandbox, accès bash, outils d'écriture de fichiers). Il génère un `config.yaml` minimal et écrit vos clés dans `.env`. Comptez environ 2 minutes.
|
||
|
||
Exécutez `make doctor` à tout moment pour vérifier votre configuration et obtenir des pistes de correction concrètes.
|
||
Si vous ouvrez une issue GitHub à propos d'un problème de configuration ou d'exécution en local, exécutez
|
||
`make support-bundle`. La commande affiche les prochaines étapes pour le rapporteur, écrit un fichier
|
||
`*-issue-summary.md` à coller dans l'issue, un fichier `*-issue-draft.md` destiné au dépôt d'issue
|
||
assisté par IA, ainsi qu'un zip de preuves optionnel sous
|
||
`.deer-flow/support-bundles/`. Si un assistant IA dépose l'issue, partez du brouillon et remplacez
|
||
chaque placeholder REQUIRED au lieu d'inventer les informations manquantes. N'attachez le zip que si
|
||
un mainteneur le demande, ou si le résumé seul ne suffit pas. Les mainteneurs et les outils de triage
|
||
IA peuvent commencer par `triage.json` ; le bundle ne contient que des diagnostics expurgés et des
|
||
manifestes de fichiers, et n'inclut ni `.env`, ni les messages bruts des conversations, ni le contenu
|
||
des fichiers de l'utilisateur.
|
||
|
||
> **Configuration avancée / manuelle** : si vous préférez éditer `config.yaml` directement, exécutez plutôt `make config` pour copier le template complet. Voir `config.example.yaml` pour la référence complète, y compris les providers basés sur un CLI (Codex CLI, Claude Code OAuth), OpenRouter, l'API Responses, et plus encore.
|
||
|
||
<details>
|
||
<summary>Exemples de configuration manuelle des modèles</summary>
|
||
|
||
```yaml
|
||
models:
|
||
- name: gpt-4o
|
||
display_name: GPT-4o
|
||
use: langchain_openai:ChatOpenAI
|
||
model: gpt-4o
|
||
api_key: $OPENAI_API_KEY
|
||
|
||
- name: openrouter-gemini-2.5-flash
|
||
display_name: Gemini 2.5 Flash (OpenRouter)
|
||
use: langchain_openai:ChatOpenAI
|
||
model: google/gemini-2.5-flash-preview
|
||
api_key: $OPENROUTER_API_KEY
|
||
base_url: https://openrouter.ai/api/v1
|
||
|
||
- name: gpt-5-responses
|
||
display_name: GPT-5 (Responses API)
|
||
use: langchain_openai:ChatOpenAI
|
||
model: gpt-5
|
||
api_key: $OPENAI_API_KEY
|
||
use_responses_api: true
|
||
output_version: responses/v1
|
||
|
||
- name: qwen3-32b-vllm
|
||
display_name: Qwen3 32B (vLLM)
|
||
use: deerflow.models.vllm_provider:VllmChatModel
|
||
model: Qwen/Qwen3-32B
|
||
api_key: $VLLM_API_KEY
|
||
base_url: http://localhost:8000/v1
|
||
supports_thinking: true
|
||
when_thinking_enabled:
|
||
extra_body:
|
||
chat_template_kwargs:
|
||
enable_thinking: true
|
||
```
|
||
|
||
OpenRouter et les passerelles compatibles OpenAI similaires doivent être configurés avec `langchain_openai:ChatOpenAI` et `base_url`. Si vous préférez utiliser un nom de variable d'environnement propre au fournisseur, pointez `api_key` vers cette variable explicitement (par exemple `api_key: $OPENROUTER_API_KEY`).
|
||
|
||
Pour router les modèles OpenAI via `/v1/responses`, continuez d'utiliser `langchain_openai:ChatOpenAI` et définissez `use_responses_api: true` avec `output_version: responses/v1`.
|
||
|
||
Pour vLLM 0.19.0, utilisez `deerflow.models.vllm_provider:VllmChatModel`. Pour les modèles de raisonnement de type Qwen, DeerFlow active le raisonnement via `extra_body.chat_template_kwargs.enable_thinking` et préserve le champ non standard `reasoning` de vLLM au fil des conversations multi-tours avec appels d'outils. Les anciennes configurations `thinking` sont normalisées automatiquement pour assurer la rétrocompatibilité. Les modèles de raisonnement peuvent aussi exiger que le serveur soit démarré avec `--reasoning-parser ...`. Si votre déploiement vLLM local accepte n'importe quelle clé API non vide, vous pouvez tout de même définir `VLLM_API_KEY` avec une valeur factice.
|
||
|
||
Exemples de providers basés sur un CLI :
|
||
|
||
```yaml
|
||
models:
|
||
- name: gpt-5.4
|
||
display_name: GPT-5.4 (Codex CLI)
|
||
use: deerflow.models.openai_codex_provider:CodexChatModel
|
||
model: gpt-5.4
|
||
supports_thinking: true
|
||
supports_reasoning_effort: true
|
||
|
||
- name: claude-sonnet-4.6
|
||
display_name: Claude Sonnet 4.6 (Claude Code OAuth)
|
||
use: deerflow.models.claude_provider:ClaudeChatModel
|
||
model: claude-sonnet-4-6
|
||
max_tokens: 4096
|
||
supports_thinking: true
|
||
```
|
||
|
||
- Codex CLI lit `~/.codex/auth.json`
|
||
- Claude Code accepte `CLAUDE_CODE_OAUTH_TOKEN`, `ANTHROPIC_AUTH_TOKEN`, `CLAUDE_CODE_CREDENTIALS_PATH`, ou `~/.claude/.credentials.json`
|
||
- Les entrées d'agents ACP sont distinctes des providers de modèles — si vous configurez `acp_agents.codex`, pointez-le vers un adaptateur Codex ACP tel que `npx -y @zed-industries/codex-acp`
|
||
- Sur macOS, exportez l'auth Claude Code explicitement si nécessaire :
|
||
|
||
```bash
|
||
eval "$(python3 scripts/export_claude_code_oauth.py --print-export)"
|
||
```
|
||
|
||
Les clés API peuvent aussi être définies manuellement dans `.env` (recommandé) ou exportées dans votre shell :
|
||
|
||
```bash
|
||
OPENAI_API_KEY=your-openai-api-key
|
||
TAVILY_API_KEY=your-tavily-api-key
|
||
```
|
||
|
||
</details>
|
||
|
||
### Lancer l'application
|
||
|
||
#### Option 1 : Docker (recommandé)
|
||
|
||
**Développement** (hot-reload, montage des sources) :
|
||
|
||
```bash
|
||
make docker-init # Pull sandbox image (only once or when image updates)
|
||
make docker-start # Start services (auto-detects sandbox mode from config.yaml)
|
||
```
|
||
|
||
`make docker-start` ne lance `provisioner` que si `config.yaml` utilise le mode provisioner (`sandbox.use: deerflow.community.aio_sandbox:AioSandboxProvider` avec `provisioner_url`).
|
||
Les processus backend récupèrent automatiquement les changements dans `config.yaml` au prochain accès à la configuration, donc les mises à jour de métadonnées des modèles ne nécessitent pas de redémarrage manuel en développement.
|
||
|
||
> [!TIP]
|
||
> Sous Linux, si les commandes Docker échouent avec `permission denied while trying to connect to the Docker daemon socket at unix:///var/run/docker.sock`, ajoutez votre utilisateur au groupe `docker` et reconnectez-vous avant de réessayer. Voir [CONTRIBUTING.md](CONTRIBUTING.md#linux-docker-daemon-permission-denied) pour la solution complète.
|
||
|
||
**Production** (build des images en local, montage de la config et des données) :
|
||
|
||
```bash
|
||
make up # Build images and start all production services
|
||
make down # Stop and remove containers
|
||
```
|
||
|
||
> [!NOTE]
|
||
> Le runtime d'agent s'exécute actuellement dans la Gateway. nginx réécrit `/api/langgraph/*` vers l'API compatible LangGraph servie par la Gateway.
|
||
|
||
Accès : http://localhost:2026
|
||
|
||
Voir [CONTRIBUTING.md](CONTRIBUTING.md) pour le guide complet de développement avec Docker.
|
||
|
||
#### Option 2 : Développement local
|
||
|
||
Si vous préférez lancer les services en local :
|
||
|
||
Prérequis : complétez d'abord les étapes de « Configuration » ci-dessus (`make setup`). `make dev` nécessite un fichier `config.yaml` valide à la racine du projet. Définissez `DEER_FLOW_PROJECT_ROOT` pour indiquer explicitement cette racine, ou `DEER_FLOW_CONFIG_PATH` pour pointer vers un fichier de configuration précis. L'état d'exécution est écrit par défaut dans `.deer-flow` sous la racine du projet et peut être déplacé avec `DEER_FLOW_HOME` ; les skills sont lus par défaut depuis `skills/` sous la racine du projet et peuvent être déplacés avec `DEER_FLOW_SKILLS_PATH`. Exécutez `make doctor` pour vérifier votre configuration avant de démarrer.
|
||
Sous Windows, exécutez le flux de développement local depuis Git Bash. Les shells natifs `cmd.exe` et PowerShell ne sont pas pris en charge pour les scripts de service basés sur bash, et WSL n'est pas garanti car certains scripts dépendent d'utilitaires de Git for Windows comme `cygpath`.
|
||
|
||
1. **Vérifier les prérequis** :
|
||
```bash
|
||
make check # Verifies Node.js 22+, pnpm, uv, nginx
|
||
```
|
||
|
||
2. **Installer les dépendances** :
|
||
```bash
|
||
make install # Install backend + frontend dependencies
|
||
```
|
||
|
||
3. **(Optionnel) Pré-télécharger l'image sandbox** :
|
||
```bash
|
||
# Recommended if using Docker/Container-based sandbox
|
||
make setup-sandbox
|
||
```
|
||
|
||
4. **Démarrer les services** :
|
||
```bash
|
||
make dev
|
||
```
|
||
|
||
5. **Accès** : http://localhost:2026
|
||
|
||
### Avancé
|
||
#### Mode Sandbox
|
||
|
||
DeerFlow supporte plusieurs modes d'exécution sandbox :
|
||
- **Exécution locale** (exécute le code sandbox directement sur la machine hôte)
|
||
- **Exécution Docker** (exécute le code sandbox dans des conteneurs Docker isolés)
|
||
- **Exécution Docker avec Kubernetes** (exécute le code sandbox dans des pods Kubernetes via le service provisioner)
|
||
|
||
En développement Docker, le démarrage des services suit le mode sandbox défini dans `config.yaml`. En mode Local/Docker, `provisioner` n'est pas démarré.
|
||
|
||
Voir le [Guide de configuration Sandbox](backend/docs/CONFIGURATION.md#sandbox) pour configurer le mode de votre choix.
|
||
|
||
#### Serveur MCP
|
||
|
||
DeerFlow supporte des serveurs MCP et des skills configurables pour étendre ses capacités.
|
||
Pour les serveurs MCP HTTP/SSE, les flux de tokens OAuth sont supportés (`client_credentials`, `refresh_token`).
|
||
Voir le [Guide MCP Server](backend/docs/MCP_SERVER.md) pour les instructions détaillées.
|
||
|
||
#### Canaux de messagerie
|
||
|
||
DeerFlow peut recevoir des tâches depuis des applications de messagerie. Les canaux démarrent automatiquement une fois configurés — aucune IP publique n'est requise.
|
||
|
||
DeerFlow peut aussi exposer des connexions de canaux IM appartenant à l'utilisateur dans l'UI du workspace. Quand `channel_connections` est activé, les utilisateurs connectés peuvent lier Telegram, Slack, Discord, Feishu/Lark, DingTalk, WeChat, WeCom, QQ ou Buzz depuis la barre latérale / Settings > Channels. Cela réutilise les transports sortants `channels.*` existants, donc aucune IP publique ni URL de callback provider n'est requise. Les messages IM entrants s'exécutent ensuite sous le compte utilisateur DeerFlow connecté. Voir [IM Channel Connections](backend/docs/IM_CHANNEL_CONNECTIONS.md) pour la configuration et les notes de sécurité.
|
||
|
||
| Canal | Transport | Difficulté |
|
||
|---------|-----------|------------|
|
||
| Telegram | Bot API (long-polling) | Facile |
|
||
| Slack | Socket Mode | Modérée |
|
||
| Feishu / Lark | WebSocket | Modérée |
|
||
| WeChat | Tencent iLink (long-polling) | Modérée |
|
||
| WeCom | WebSocket | Modérée |
|
||
| DingTalk | Stream Push (WebSocket) | Modérée |
|
||
| QQ | WebSocket (texte : messages privés et mentions de groupe) | Modérée |
|
||
| Buzz | Relais Nostr (WebSocket, NIP-42) | Modérée |
|
||
|
||
**Configuration dans `config.yaml` :**
|
||
|
||
```yaml
|
||
channels:
|
||
# LangGraph-compatible Gateway API base URL (default: http://localhost:8001/api)
|
||
langgraph_url: http://localhost:8001/api
|
||
# Gateway API URL (default: http://localhost:8001)
|
||
gateway_url: http://localhost:8001
|
||
|
||
# Optional: global session defaults for all mobile channels
|
||
session:
|
||
assistant_id: lead_agent
|
||
config:
|
||
recursion_limit: 100
|
||
context:
|
||
thinking_enabled: true
|
||
is_plan_mode: false
|
||
subagent_enabled: false
|
||
|
||
feishu:
|
||
enabled: true
|
||
app_id: $FEISHU_APP_ID
|
||
app_secret: $FEISHU_APP_SECRET
|
||
# domain: https://open.feishu.cn # China (default)
|
||
# domain: https://open.larksuite.com # International
|
||
|
||
wecom:
|
||
enabled: true
|
||
bot_id: $WECOM_BOT_ID
|
||
bot_secret: $WECOM_BOT_SECRET
|
||
|
||
slack:
|
||
enabled: true
|
||
bot_token: $SLACK_BOT_TOKEN # xoxb-...
|
||
app_token: $SLACK_APP_TOKEN # xapp-... (Socket Mode)
|
||
allowed_users: [] # empty = allow all
|
||
|
||
telegram:
|
||
enabled: true
|
||
bot_token: $TELEGRAM_BOT_TOKEN
|
||
allowed_users: [] # identifiants numériques, pas de @pseudo ; vide = tout le monde autorisé
|
||
|
||
# Optional: per-channel / per-user session settings
|
||
session:
|
||
assistant_id: mobile_agent
|
||
context:
|
||
thinking_enabled: false
|
||
users:
|
||
"123456789":
|
||
assistant_id: vip_agent
|
||
config:
|
||
recursion_limit: 150
|
||
context:
|
||
thinking_enabled: true
|
||
subagent_enabled: true
|
||
|
||
wechat:
|
||
enabled: false
|
||
bot_token: $WECHAT_BOT_TOKEN
|
||
ilink_bot_id: $WECHAT_ILINK_BOT_ID
|
||
qrcode_login_enabled: true # optionnel : autorise le bootstrap QR à la première utilisation quand bot_token est absent
|
||
allowed_users: [] # vide = tout le monde autorisé
|
||
polling_timeout: 35
|
||
state_dir: ./.deer-flow/wechat/state
|
||
max_inbound_image_bytes: 20971520
|
||
max_outbound_image_bytes: 20971520
|
||
max_inbound_file_bytes: 52428800
|
||
max_outbound_file_bytes: 52428800
|
||
|
||
dingtalk:
|
||
enabled: true
|
||
client_id: $DINGTALK_CLIENT_ID # ClientId depuis DingTalk Open Platform
|
||
client_secret: $DINGTALK_CLIENT_SECRET # ClientSecret depuis DingTalk Open Platform
|
||
allowed_users: [] # vide = tout le monde autorisé
|
||
card_template_id: "" # Optionnel : ID de modèle AI Card pour l'effet machine à écrire en streaming
|
||
```
|
||
|
||
Définissez les clés API correspondantes dans votre fichier `.env` :
|
||
|
||
```bash
|
||
# Telegram
|
||
TELEGRAM_BOT_TOKEN=123456789:ABCdefGHIjklMNOpqrSTUvwxYZ
|
||
|
||
# Slack
|
||
SLACK_BOT_TOKEN=xoxb-...
|
||
SLACK_APP_TOKEN=xapp-...
|
||
|
||
# Feishu / Lark
|
||
FEISHU_APP_ID=cli_xxxx
|
||
FEISHU_APP_SECRET=your_app_secret
|
||
|
||
# WeChat iLink
|
||
WECHAT_BOT_TOKEN=your_ilink_bot_token
|
||
WECHAT_ILINK_BOT_ID=your_ilink_bot_id
|
||
|
||
# WeCom
|
||
WECOM_BOT_ID=your_bot_id
|
||
WECOM_BOT_SECRET=your_bot_secret
|
||
|
||
# DingTalk
|
||
DINGTALK_CLIENT_ID=your_client_id
|
||
DINGTALK_CLIENT_SECRET=your_client_secret
|
||
```
|
||
|
||
**Configuration Telegram**
|
||
|
||
1. Ouvrez une conversation avec [@BotFather](https://t.me/BotFather), envoyez `/newbot`, et copiez le token HTTP API.
|
||
2. Définissez `TELEGRAM_BOT_TOKEN` dans `.env` et activez le canal dans `config.yaml`.
|
||
|
||
**Configuration Slack**
|
||
|
||
1. Créez une Slack App sur [api.slack.com/apps](https://api.slack.com/apps) → Create New App → From scratch.
|
||
2. Dans **OAuth & Permissions**, ajoutez les Bot Token Scopes : `app_mentions:read`, `chat:write`, `im:history`, `im:read`, `im:write`, `files:write`.
|
||
3. Activez le **Socket Mode** → générez un App-Level Token (`xapp-…`) avec le scope `connections:write`.
|
||
4. Dans **Event Subscriptions**, abonnez-vous aux bot events : `app_mention`, `message.im`.
|
||
5. Définissez `SLACK_BOT_TOKEN` et `SLACK_APP_TOKEN` dans `.env` et activez le canal dans `config.yaml`.
|
||
|
||
**Configuration Feishu / Lark**
|
||
|
||
1. Créez une application sur [Feishu Open Platform](https://open.feishu.cn/) → activez la capacité **Bot**.
|
||
2. Ajoutez les permissions : `im:message`, `im:message.p2p_msg:readonly`, `im:resource`.
|
||
3. Dans **Events**, abonnez-vous à `im.message.receive_v1` et sélectionnez le mode **Long Connection**.
|
||
4. Copiez l'App ID et l'App Secret. Définissez `FEISHU_APP_ID` et `FEISHU_APP_SECRET` dans `.env` et activez le canal dans `config.yaml`.
|
||
|
||
**Configuration WeChat**
|
||
|
||
1. Activez le canal `wechat` dans `config.yaml`.
|
||
2. Soit définissez `WECHAT_BOT_TOKEN` dans `.env`, soit mettez `qrcode_login_enabled: true` pour le bootstrap QR à la première utilisation.
|
||
3. Quand `bot_token` est absent et que le bootstrap QR est activé, surveillez les logs du backend pour le contenu du QR renvoyé par iLink et complétez le flux de binding.
|
||
4. Une fois le flux QR réussi, DeerFlow persiste le token acquis sous `state_dir` pour les redémarrages ultérieurs.
|
||
5. Pour les déploiements Docker Compose, gardez `state_dir` sur un volume persistant afin que le curseur `get_updates_buf` et l'état d'auth sauvegardé survivent aux redémarrages.
|
||
|
||
**Configuration WeCom**
|
||
|
||
1. Créez un bot sur la plateforme WeCom AI Bot et obtenez le `bot_id` et le `bot_secret`.
|
||
2. Activez `channels.wecom` dans `config.yaml` et renseignez `bot_id` / `bot_secret`.
|
||
3. Définissez `WECOM_BOT_ID` et `WECOM_BOT_SECRET` dans `.env`.
|
||
4. Assurez-vous que les dépendances du backend incluent `wecom-aibot-python-sdk`. Le canal utilise une connexion longue WebSocket et ne nécessite pas d'URL de callback publique.
|
||
5. L'intégration actuelle prend en charge les messages entrants texte, image et fichier. Les images/fichiers finaux générés par l'agent sont aussi renvoyés dans la conversation WeCom.
|
||
|
||
**Configuration DingTalk**
|
||
|
||
1. Créez une application sur [DingTalk Open Platform](https://open.dingtalk.com/) et activez la capacité **Robot**.
|
||
2. Dans la page de configuration du robot, définissez le mode de réception des messages sur **Stream**.
|
||
3. Copiez le `Client ID` et le `Client Secret`. Définissez `DINGTALK_CLIENT_ID` et `DINGTALK_CLIENT_SECRET` dans `.env` et activez le canal dans `config.yaml`.
|
||
4. *(Optionnel)* Pour activer les réponses en streaming AI Card (effet machine à écrire), créez un modèle **AI Card** sur la [plateforme de cartes DingTalk](https://open.dingtalk.com/document/dingstart/typewriter-effect-streaming-ai-card), puis définissez `card_template_id` dans `config.yaml` avec l'ID du modèle. Vous devez également demander les permissions `Card.Streaming.Write` et `Card.Instance.Write`.
|
||
|
||
**Commandes**
|
||
|
||
Une fois un canal connecté, vous pouvez interagir avec DeerFlow directement depuis le chat :
|
||
|
||
| Commande | Description |
|
||
|---------|-------------|
|
||
| `/new` | Démarrer une nouvelle conversation |
|
||
| `/status` | Afficher les infos du thread en cours |
|
||
| `/models` | Lister les modèles disponibles |
|
||
| `/memory` | Consulter la mémoire |
|
||
| `/help` | Afficher l'aide |
|
||
|
||
> Les messages sans préfixe de commande sont traités comme du chat classique — DeerFlow crée un thread et répond de manière conversationnelle.
|
||
|
||
#### Traçage LangSmith
|
||
|
||
DeerFlow intègre nativement [LangSmith](https://smith.langchain.com) pour l'observabilité. Une fois activé, tous les appels LLM, les exécutions d'agents et les exécutions d'outils sont tracés et visibles dans le tableau de bord LangSmith.
|
||
|
||
Ajoutez les lignes suivantes à votre fichier `.env` :
|
||
|
||
```bash
|
||
LANGSMITH_TRACING=true
|
||
LANGSMITH_ENDPOINT=https://api.smith.langchain.com
|
||
LANGSMITH_API_KEY=lsv2_pt_xxxxxxxxxxxxxxxx
|
||
LANGSMITH_PROJECT=xxx
|
||
```
|
||
|
||
#### Traçage Langfuse
|
||
|
||
DeerFlow prend également en charge l'observabilité via [Langfuse](https://langfuse.com) pour les exécutions compatibles LangChain.
|
||
|
||
Ajoutez les lignes suivantes à votre fichier `.env` :
|
||
|
||
```bash
|
||
LANGFUSE_TRACING=true
|
||
LANGFUSE_PUBLIC_KEY=pk-lf-xxxxxxxxxxxxxxxx
|
||
LANGFUSE_SECRET_KEY=sk-lf-xxxxxxxxxxxxxxxx
|
||
LANGFUSE_BASE_URL=https://cloud.langfuse.com
|
||
```
|
||
|
||
Si vous utilisez une instance Langfuse auto-hébergée, définissez `LANGFUSE_BASE_URL` sur l'URL de votre déploiement.
|
||
|
||
**Champs de corrélation des traces.** Chaque exécution d'agent est annotée avec les attributs de trace réservés de Langfuse afin que les pages Sessions et Users se remplissent automatiquement :
|
||
|
||
- `session_id` = `thread_id` de LangGraph — regroupe toutes les traces d'une même conversation
|
||
- `user_id` = utilisateur effectif issu de `get_effective_user_id()` (revient à `default` en mode sans authentification)
|
||
- `trace_name` = assistant id (par défaut `lead-agent`)
|
||
- `tags` = `[env:<DEER_FLOW_ENV>, model:<model_name>]` (omis lorsqu'ils ne sont pas définis)
|
||
- `metadata.deerflow_trace_id` = id de corrélation de requête DeerFlow, toujours identique à l'en-tête de réponse `X-Trace-Id` renvoyé par la même requête (`logging.enhance.enabled` contrôle uniquement si cet id est écrit dans les logs)
|
||
|
||
Ces champs sont injectés dans `RunnableConfig.metadata` à la racine de l'invocation du graphe, à la fois pour le chemin gateway (`runtime/runs/worker.py::run_agent`) et le chemin embarqué (`client.py::DeerFlowClient.stream`), de sorte que tout callback compatible LangChain puisse les lire. Définissez `DEER_FLOW_ENV` (ou `ENVIRONMENT`) pour étiqueter les traces par environnement de déploiement.
|
||
|
||
#### Utiliser les deux fournisseurs
|
||
|
||
Si LangSmith et Langfuse sont tous deux activés, DeerFlow attache les deux callbacks de traçage et rapporte la même activité de modèle aux deux systèmes.
|
||
|
||
Si un fournisseur est explicitement activé mais qu'il manque les identifiants requis, ou si son callback échoue à s'initialiser, DeerFlow échoue immédiatement (fail fast) lors de l'initialisation du traçage à la création du modèle, et le message d'erreur indique le fournisseur à l'origine de l'échec.
|
||
|
||
Pour les déploiements Docker, le traçage est désactivé par défaut. Définissez `LANGSMITH_TRACING=true` et `LANGSMITH_API_KEY` dans votre `.env` pour l'activer.
|
||
|
||
## Du Deep Research au Super Agent Harness
|
||
|
||
DeerFlow a démarré comme un framework de Deep Research — et la communauté s'en est emparée. Depuis le lancement, les développeurs l'ont poussé bien au-delà de la recherche : construction de pipelines de données, génération de présentations, mise en place de dashboards, automatisation de workflows de contenu. Des usages qu'on n'avait jamais anticipés.
|
||
|
||
Ça nous a révélé quelque chose d'important : DeerFlow n'était pas qu'un simple outil de recherche. C'était un **harness** — un runtime qui donne aux agents l'infrastructure nécessaire pour vraiment accomplir du travail.
|
||
|
||
On l'a donc reconstruit de zéro.
|
||
|
||
DeerFlow 2.0 n'est plus un framework à assembler soi-même. C'est un super agent harness — clé en main et entièrement extensible. Construit sur LangGraph et LangChain, il embarque tout ce dont un agent a besoin out of the box : un système de fichiers, de la mémoire, des skills, une exécution sandboxée, et la capacité de planifier et de lancer des sub-agents pour les tâches complexes et multi-étapes.
|
||
|
||
Utilisez-le tel quel. Ou démontez-le et faites-en le vôtre.
|
||
|
||
## Fonctionnalités principales
|
||
|
||
### Skills et outils
|
||
|
||
Les skills sont ce qui permet à DeerFlow de faire *pratiquement n'importe quoi*.
|
||
|
||
Un Agent Skill standard est un module de capacité structuré — un fichier Markdown qui définit un workflow, des bonnes pratiques et des références vers des ressources associées. DeerFlow est livré avec des skills intégrés pour la recherche, la génération de rapports, la création de présentations, les pages web, la génération d'images et de vidéos, et bien plus. Mais la vraie force réside dans l'extensibilité : ajoutez vos propres skills, remplacez ceux fournis, ou combinez-les en workflows composites.
|
||
|
||
Les skills sont chargés progressivement — uniquement quand la tâche le nécessite, pas tous en même temps. Ça permet de garder la fenêtre de contexte légère et de bien fonctionner même avec des modèles sensibles au nombre de tokens.
|
||
|
||
Quand vous installez des archives `.skill` via le Gateway, DeerFlow accepte les métadonnées frontmatter optionnelles standard comme `version`, `author` et `compatibility`, plutôt que de rejeter des skills externes par ailleurs valides.
|
||
|
||
Les outils suivent la même philosophie. DeerFlow est livré avec un ensemble d'outils de base — recherche web, fetch de pages web, opérations sur les fichiers, exécution bash — et supporte les outils custom via des serveurs MCP et des fonctions Python. Remplacez n'importe quoi. Ajoutez n'importe quoi.
|
||
|
||
Les suggestions de suivi générées par le Gateway normalisent désormais aussi bien la sortie texte brut du modèle que le contenu riche au format bloc/liste avant de parser la réponse en tableau JSON, de sorte que les wrappers de contenu propres à chaque provider ne suppriment plus silencieusement les suggestions.
|
||
|
||
```
|
||
# Paths inside the sandbox container
|
||
/mnt/skills/public
|
||
├── research/SKILL.md
|
||
├── report-generation/SKILL.md
|
||
├── slide-creation/SKILL.md
|
||
├── web-page/SKILL.md
|
||
└── image-generation/SKILL.md
|
||
|
||
/mnt/skills/custom
|
||
└── your-custom-skill/SKILL.md ← yours
|
||
```
|
||
|
||
#### Intégration Claude Code
|
||
|
||
Le skill `claude-to-deerflow` vous permet d'interagir avec une instance DeerFlow en cours d'exécution directement depuis [Claude Code](https://docs.anthropic.com/en/docs/claude-code). Envoyez des tâches de recherche, vérifiez le statut, gérez les threads — le tout sans quitter le terminal.
|
||
|
||
**Installer le skill** :
|
||
|
||
```bash
|
||
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
|
||
```
|
||
|
||
Assurez-vous ensuite que DeerFlow tourne (par défaut sur `http://localhost:2026`) et utilisez la commande `/claude-to-deerflow` dans Claude Code.
|
||
|
||
**Ce que vous pouvez faire** :
|
||
- Envoyer des messages à DeerFlow et recevoir des réponses en streaming
|
||
- Choisir le mode d'exécution : flash (rapide), standard, pro (planification), ultra (sub-agents)
|
||
- Vérifier la santé de DeerFlow, lister les modèles/skills/agents
|
||
- Gérer les threads et l'historique des conversations
|
||
- Upload des fichiers pour analyse
|
||
|
||
**Variables d'environnement** (optionnel, pour des endpoints custom) :
|
||
|
||
```bash
|
||
DEERFLOW_URL=http://localhost:2026 # Unified proxy base URL
|
||
DEERFLOW_GATEWAY_URL=http://localhost:2026 # Gateway API
|
||
DEERFLOW_LANGGRAPH_URL=http://localhost:2026/api/langgraph # LangGraph API
|
||
```
|
||
|
||
Voir [`skills/public/claude-to-deerflow/SKILL.md`](skills/public/claude-to-deerflow/SKILL.md) pour la référence API complète.
|
||
|
||
### Objectifs de session (Session Goals)
|
||
|
||
Utilisez `/goal <condition de complétion>` pour attacher une condition de complétion active au thread courant. Le goal est un état de portée thread, pas une activation de skill — il reste actif entre les tours jusqu'à ce que DeerFlow détermine qu'il a été satisfait, ou jusqu'à ce que vous le supprimiez.
|
||
|
||
Commandes prises en charge :
|
||
|
||
```text
|
||
/goal finish the implementation and make all tests pass
|
||
/goal # afficher le goal actif
|
||
/goal clear # le supprimer
|
||
```
|
||
|
||
Après chaque exécution menée par la Gateway, DeerFlow évalue la conversation visible, y compris les appels d'outils de l'assistant et leurs résultats abrégés, par rapport au goal actif à l'aide d'un modèle évaluateur non-thinking. Un résultat d'outil réussi ne suffit pas à satisfaire un goal, et lorsque l'assistant a dû deviner une information manquante ou ambiguë, l'évaluateur renvoie `needs_user_input`. L'évaluateur doit renvoyer un blocker typé (`missing_evidence`, `needs_user_input`, `run_failed`, `external_wait` ou `goal_not_met_yet`) accompagné de preuves visibles. DeerFlow n'injecte une hidden continuation que si le dernier tour assistant est durablement checkpointé, que le blocker est `goal_not_met_yet`, que le thread n'a pas changé durant l'évaluation et que le disjoncteur de non-progression n'a pas déclenché. Le plafond de sécurité est de 8 hidden continuations par défaut, et les évaluations identiques de non-progression s'arrêtent après 2 tentatives répétées. `/goal clear` ainsi que toute nouvelle saisie utilisateur ont priorité sur les continuations en file d'attente. Lorsque le goal est satisfait, DeerFlow le supprime automatiquement et publie l'état mis à jour du thread.
|
||
|
||
Le Web UI affiche le goal actif au-dessus de la zone de saisie. La même commande est disponible depuis le TUI et les canaux IM pris en charge. Dans le Web UI et les canaux IM pris en charge, définir `/goal <condition de complétion>` lance aussi une exécution avec la condition comme tâche ; les commandes de statut et de suppression ne gèrent que l'état du goal lui-même.
|
||
|
||
### Sub-Agents
|
||
|
||
Les tâches complexes tiennent rarement en une seule passe. DeerFlow les décompose.
|
||
|
||
L'agent principal peut lancer des sub-agents à la volée — chacun avec son propre contexte délimité, ses outils et ses conditions d'arrêt. Les sub-agents s'exécutent en parallèle quand c'est possible, remontent des résultats structurés, et l'agent principal synthétise le tout en une sortie cohérente.
|
||
|
||
C'est comme ça que DeerFlow gère les tâches qui prennent de quelques minutes à plusieurs heures : une tâche de recherche peut se déployer en une dizaine de sub-agents, chacun explorant un angle différent, puis converger vers un seul rapport — ou un site web — ou un jeu de slides avec des visuels générés. Un seul harness, de nombreuses mains.
|
||
|
||
### Sandbox et système de fichiers
|
||
|
||
DeerFlow ne se contente pas de *parler* de faire les choses. Il dispose de son propre ordinateur.
|
||
|
||
Chaque tâche s'exécute dans un conteneur Docker isolé avec un système de fichiers complet — skills, workspace, uploads, outputs. L'agent lit, écrit et édite des fichiers. Il exécute des commandes bash et du code. Il visualise des images. Le tout sandboxé, le tout auditable, zéro contamination entre les sessions.
|
||
|
||
C'est la différence entre un chatbot avec accès à des outils et un agent doté d'un véritable environnement d'exécution.
|
||
|
||
```
|
||
# Paths inside the sandbox container
|
||
/mnt/user-data/
|
||
├── uploads/ ← your files
|
||
├── workspace/ ← agents' working directory
|
||
└── outputs/ ← final deliverables
|
||
```
|
||
|
||
### Context Engineering
|
||
|
||
**Contexte isolé des Sub-Agents** : chaque sub-agent s'exécute dans son propre contexte isolé. Il ne peut voir ni le contexte de l'agent principal, ni celui des autres sub-agents. L'objectif est de garantir que chaque sub-agent reste concentré sur sa tâche sans être parasité par des informations non pertinentes.
|
||
|
||
**Résumé** : au sein d'une session, DeerFlow gère le contexte de manière agressive — en résumant les sous-tâches terminées, en déchargeant les résultats intermédiaires vers le système de fichiers, en compressant ce qui n'est plus immédiatement pertinent. Ça lui permet de rester efficace sur des tâches longues et multi-étapes sans faire exploser la fenêtre de contexte.
|
||
|
||
### Mémoire à long terme
|
||
|
||
La plupart des agents oublient tout dès qu'une conversation se termine. DeerFlow, lui, se souvient.
|
||
|
||
D'une session à l'autre, DeerFlow construit une mémoire persistante de votre profil, de vos préférences et de vos connaissances accumulées. Plus vous l'utilisez, mieux il vous connaît — votre style d'écriture, votre stack technique, vos workflows récurrents. La mémoire est stockée localement et reste sous votre contrôle.
|
||
|
||
Les mises à jour de la mémoire ignorent désormais les entrées de faits en double au moment de l'application, de sorte que les préférences et le contexte répétés ne s'accumulent plus indéfiniment entre les sessions.
|
||
|
||
## Modèles recommandés
|
||
|
||
DeerFlow est agnostique en termes de modèle — il fonctionne avec n'importe quel LLM implémentant l'API compatible OpenAI. Cela dit, il offre de meilleures performances avec des modèles qui supportent :
|
||
|
||
- **De longues fenêtres de contexte** (100k+ tokens) pour la recherche approfondie et les tâches multi-étapes
|
||
- **Des capacités de raisonnement** pour la planification adaptative et la décomposition de tâches complexes
|
||
- **Des entrées multimodales** pour la compréhension d'images et de vidéos
|
||
- **Un usage fiable des outils (tool use)** pour des appels de fonctions et des sorties structurées fiables
|
||
|
||
## Client Python intégré
|
||
|
||
DeerFlow peut être utilisé comme bibliothèque Python intégrée sans lancer l'ensemble des services HTTP. Le `DeerFlowClient` fournit un accès direct in-process à toutes les capacités d'agent et de Gateway, en retournant les mêmes schémas de réponse que l'API HTTP Gateway. Le HTTP Gateway expose également `DELETE /api/threads/{thread_id}` pour supprimer les données de thread locales gérées par DeerFlow après la suppression du thread LangGraph :
|
||
|
||
```python
|
||
from deerflow.client import DeerFlowClient
|
||
|
||
client = DeerFlowClient()
|
||
|
||
# Chat
|
||
response = client.chat("Analyze this paper for me", thread_id="my-thread")
|
||
|
||
# Streaming (LangGraph SSE protocol: values, messages-tuple, end)
|
||
for event in client.stream("hello"):
|
||
if event.type == "messages-tuple" and event.data.get("type") == "ai":
|
||
print(event.data["content"])
|
||
|
||
# Configuration & management — returns Gateway-aligned dicts
|
||
models = client.list_models() # {"models": [...]}
|
||
skills = client.list_skills() # {"skills": [...]}
|
||
client.update_skill("web-search", enabled=True)
|
||
client.upload_files("thread-1", ["./report.pdf"]) # {"success": True, "files": [...]}
|
||
client.set_goal("thread-1", "finish the implementation and make all tests pass")
|
||
client.get_goal("thread-1") # {"goal": {...}} or {"goal": None}
|
||
client.clear_goal("thread-1")
|
||
```
|
||
|
||
Toutes les méthodes retournant des dicts sont validées en CI contre les modèles de réponse Pydantic du Gateway (`TestGatewayConformance`), garantissant que le client intégré reste synchronisé avec les schémas de l'API HTTP. Voir `backend/packages/harness/deerflow/client.py` pour la documentation API complète.
|
||
|
||
## Projets
|
||
|
||
Les projets regroupent des conversations liées sous un nom partagé, des instructions et une étagère de documents.
|
||
|
||
Une conversation rejoint un projet au moment de sa création (lorsqu'un projet est sélectionné) ou plus tard via le menu de déplacement. Les exécutions ne modifient jamais l'appartenance : l'envoi d'un message ne peut pas affecter ou réaffecter une conversation. Déplacer une conversation hors d'un projet la laisse non affectée jusqu'à ce qu'elle soit à nouveau explicitement déplacée.
|
||
|
||
Le déplacement d'une conversation actualise son rattachement dans l'en-tête ainsi que les listes de projets, y compris lorsqu'une requête de métadonnées plus ancienne est encore en cours.
|
||
|
||
Les projets exigent les tables et colonnes de base de données actuelles. Une base de données estampillée `0019_thread_incarnations` issue de l'ancien déploiement basé sur 0018 est rejetée au démarrage si le schéma des projets est absent. Suivez la [procédure de récupération hors ligne de la base de données](docs/database-forward-revision-recovery.md) avant de démarrer ce build sur cette base.
|
||
|
||
### Instructions de projet
|
||
|
||
Chaque projet stocke des instructions en forme libre — contexte, conventions et contraintes s'appliquant à toutes les conversations du projet — modifiables dans l'onglet Instructions de la page du projet, avec un compteur d'octets en direct. Lorsqu'une exécution démarre sur un thread membre, le Gateway fige une seule fois l'état actuel du projet et rend les instructions sous forme d'un bloc `<project>` borné, propre à cette requête et réservé à cette exécution : le bloc n'entre jamais dans le prompt système ni dans l'historique persisté, et chaque nouvelle exécution voit les dernières instructions enregistrées. Les instructions sont plafonnées à `projects.instructions_max_bytes` octets UTF-8 (par défaut 8192, plage 256–262144) ; les caractères multioctets comptent pour leur longueur en octets UTF-8. Les instructions trop longues sont rejetées avec un `422` à l'écriture et ne sont jamais tronquées silencieusement.
|
||
|
||
### Étagère de documents
|
||
|
||
Chaque projet dispose d'une étagère de documents pour les fichiers partagés par l'ensemble du projet, gérée depuis la section Documents de la page du projet :
|
||
|
||
- **Téléverser** un fichier (bouton ou glisser-déposer, un fichier par requête). Les limites de taille de l'étagère réutilisent `uploads.max_file_size` (par défaut 50 Mio) ; re-téléverser un contenu identique renvoie l'entrée existante au lieu de créer un doublon.
|
||
- **Lister** les entrées avec leur nom, taille, date de modification et provenance (téléversées vs. enregistrées depuis une conversation), et prévisualiser ou télécharger n'importe quelle entrée.
|
||
- **Enregistrer dans le projet** depuis un fichier de thread : le navigateur en lecture seule des fichiers de conversation sous l'étagère liste les téléversements et sorties des threads membres, chacun avec une action « Enregistrer dans le projet ».
|
||
- **Joindre à un thread** : copier un fichier de l'étagère vers les téléversements d'un thread via le pipeline d'ingestion normal, pour que la conversation puisse l'utiliser directement.
|
||
|
||
Les exécutions sur les threads membres reçoivent également un index `<documents>` borné, rendu à chaque exécution à partir de l'instantané figé (limité par `projects.shelf_index_max_entries` et `projects.shelf_index_max_bytes`), et l'agent peut parcourir l'étagère et lire les documents avec les outils `list_project_documents` et `read_project_document`.
|
||
|
||
### Sémantique de lecture des projets archivés
|
||
|
||
Archiver un projet gèle les écritures mais conserve les lectures. Les threads d'un projet archivé s'exécutent toujours et reçoivent toujours les instructions du projet et l'index de l'étagère, et l'étagère reste entièrement lisible : listage, prévisualisation/téléchargement, navigateur de fichiers de conversation et jonction à un thread continuent de fonctionner. Les téléversements, l'enregistrement dans le projet et le déplacement de fichiers individuels de l'étagère vers la corbeille exigent un projet actif, et un document mis à la corbeille ne peut pas être restauré dans un projet archivé. La suppression d'un projet archivé reste possible et déplace toute son étagère vers la corbeille.
|
||
|
||
### Corbeille
|
||
|
||
Supprimer un document de l'étagère le déplace vers la corbeille au lieu de l'effacer : l'entrée conserve ses octets et un instantané de son projet d'origine pendant `projects.trash_retention_days` (par défaut 30) avant que le balayage de rétention puisse la purger définitivement. La page `/workspace/trash` — accessible depuis la section Documents de la page du projet et l'en-tête Projets de la barre latérale — liste les documents mis à la corbeille avec leur projet d'origine et la rétention restante, avec des actions Restaurer et Supprimer définitivement par entrée, plus une action Vider la corbeille qui supprime définitivement tous les documents de la corbeille — immédiatement, et non après la fenêtre de rétention ; la fenêtre ne fait que borner la durée pendant laquelle une entrée peut y rester avant que le balayage de rétention ne la récupère. La restauration renvoie le document à son projet d'origine, ou à un projet de votre choix lorsque l'origine a disparu ou est archivée ; si la cible contient déjà un fichier actif identique, les entrées fusionnent. La suppression d'un projet déplace toute son étagère vers la corbeille en une seule étape.
|
||
|
||
## Tâches planifiées (Scheduled Tasks)
|
||
|
||
DeerFlow inclut désormais un MVP de tâches planifiées (scheduled-task) de premier niveau dans le workspace.
|
||
|
||
Capacités actuelles du MVP :
|
||
|
||
- Gérer les tâches depuis `/workspace/scheduled-tasks`
|
||
- Choisir si chaque tâche planifiée réutilise un thread ou crée un nouveau thread à chaque exécution
|
||
- Prendre en charge les planifications `once`, `cron` et `interval`
|
||
- Exécuter les tâches planifiées en arrière-plan comme des exécutions DeerFlow non interactives (`ask_clarification` n'y est pas exposé)
|
||
- Utiliser le comportement de chevauchement `skip` pour les exécutions cron dues qui entrent en collision avec une exécution active sur le même thread réutilisé
|
||
- Mettre en pause, reprendre, déclencher, inspecter l'historique et supprimer les tâches
|
||
- Exécuter le travail planifié via le cycle de vie d'exécution normal de DeerFlow
|
||
|
||
Limites actuelles du MVP :
|
||
|
||
- Pas de tâches de notification en texte seul
|
||
- Pas de cibles de dispatch canal ou GitHub
|
||
|
||
Activez le polling en arrière-plan avec `config.yaml -> scheduler.enabled`. Le déclenchement manuel utilise la même ressource scheduled-task et le même chemin d'exécution.
|
||
|
||
### Cycle de vie, plafonds de sécurité et conditions d'arrêt
|
||
|
||
- La page des tâches et l'API REST (`POST` / `PATCH /api/scheduled-tasks`) acceptent un objectif par exécution (`goal_objective`), un plafond de sécurité (`max_runs`, `end_at`) et une condition d'arrêt (`stop_condition`). Envoyer `null` dans un PATCH efface l'un de ces quatre champs ; un `end_at` sans décalage UTC est une heure locale dans le fuseau de la tâche.
|
||
- La condition d'arrêt est la règle « arrête-toi quand … » de l'utilisateur. Elle est stockée dans un champ dédié (migration `0031`), jamais dans les instructions de la tâche. DeerFlow ne l'ajoute au message d'une exécution qu'au moment où celle-ci démarre, en lui demandant d'appeler `stop_scheduled_task` lorsque la règle est remplie. Lorsque `scheduler.tool_enabled` est activé, chaque exécution planifiée peut mettre en pause sa propre planification, que la tâche ait été créée dans une conversation ou sur la page des tâches ; sinon, l'exécution signale simplement que la règle est remplie.
|
||
- Les tâches avec objectif créées sur la page des tâches sont désormais évaluées comme celles créées dans une conversation, et leurs exécutions reçoivent aussi les notes enregistrées et la référence à l'exécution précédente.
|
||
- La reprise calcule la prochaine exécution à partir de maintenant : une longue pause ne déclenche jamais d'exécution de rattrapage. Une tâche ponctuelle dont l'heure est passée renvoie `422 once_time_passed` et demande une nouvelle heure. Reprendre une tâche active ne change rien ; mettre en pause une tâche terminée renvoie `409 task_finished`.
|
||
- `max_runs` compte les exécutions automatiques sur toute la vie de la tâche ; les exécutions d'essai ne comptent jamais. Réactiver une tâche dont le plafond est atteint (reprise, ou PATCH qui réarme la planification d'une tâche terminée) renvoie `409 limits_exhausted`, sauf si la même requête renouvelle la limite épuisée : un nombre d'exécutions épuisé demande un `max_runs` plus élevé ou `null`, une heure de fin dépassée demande un `end_at` plus tardif ou `null` (repousser `end_at` seul ne relance pas une tâche dont `max_runs` est épuisé). `POST /api/scheduled-tasks/{task_id}/resume` accepte pour cela un corps facultatif `{"max_runs": …, "end_at": …}` (`null` supprime un plafond). Un PATCH qui ne change que le plafond d'une tâche terminée l'enregistre et la laisse terminée.
|
||
- Les échecs de vérification de l'objectif (évaluateur en échec, ou conversation modifiée pendant la vérification) ne comptent pas pour la pause automatique après trois échecs et ne remettent pas le compteur à zéro. Modifier l'objectif, les instructions ou la condition d'arrêt, ou ajouter une note, repart d'un nouveau compte ; la reprise le conserve.
|
||
- Tant que le planificateur de ce processus Gateway ne tourne pas, la création d'une tâche (y compris la duplication) renvoie `409 scheduler_not_running`. `GET /api/features` expose `scheduled_tasks.available`, `running`, `tool_enabled` et `min_interval_seconds`.
|
||
- Les erreurs de `/api/scheduled-tasks*` ont la forme `{"detail": {"code", "message", "params"}}` ; voir [`backend/docs/API.md`](backend/docs/API.md#scheduled-tasks) et `contracts/scheduled_task_errors_contract.json`.
|
||
- Les créneaux d'exécution sont partagés équitablement entre les propriétaires des tâches : un même propriétaire peut avoir au plus `scheduler.max_concurrent_runs_per_user` exécutions planifiées en démarrage ou en cours à la fois (2 par défaut, jamais plus que `max_concurrent_runs` ; `0` désactive ce plafond par propriétaire), et la file d'attente est vidée propriétaire par propriétaire, si bien que l'arriéré de l'un ne retarde jamais l'exécution d'un autre. Une exécution qui attend plus longtemps que `scheduler.queue_timeout_seconds` est ignorée, et l'historique indique qu'elle a attendu trop longtemps un créneau libre.
|
||
- Avec `channel_connections.enabled: true`, les mises à jour des tâches planifiées sont envoyées aux identités IM connectées du propriétaire, uniquement sur les applications qui gèrent l'envoi proactif (WeCom aujourd'hui) ; les paramètres indiquent pour chaque application si les mises à jour y sont envoyées. Chaque occurrence envoie au plus un message (exécution terminée, en échec ou objectif non atteint, pause automatique, pause par l'agent, fin de la tâche), mis en file dans la même transaction que le résultat, donc une seule fois même après une reprise sur panne. Le message se lit seul, dans la langue de votre interface web (sinon `channel_connections.notification_locale`), sans identifiants ni liens. Les essais manuels simples et les exécutions interrompues ne notifient pas.
|
||
|
||
### Créer des planifications dans une conversation
|
||
|
||
Activez `scheduler.enabled: true` et `scheduler.tool_enabled: true`, puis redémarrez le Gateway. Un tour interactif autorisé peut alors utiliser `schedule_task` pour créer, modifier, lister, mettre en pause, reprendre ou supprimer des tâches, lancer une exécution d'essai ou enregistrer une note. Par exemple : « Chaque jour ouvré à 9 h, vérifie release-checklist.md et dis-moi ce qui n'est pas coché ; arrête-toi quand tout est coché. » Dans l'application web, le résultat s'affiche sous forme de carte mise à jour en direct (planification, condition d'arrêt, boutons) et l'agent répond en une ou deux phrases ; dans les messageries (IM) et les autres tours hors web, il décrit en texte la planification, la prochaine exécution et la condition d'arrêt.
|
||
|
||
- **Tâches gérées par une conversation.** Celles qui y ont été créées et, dans une conversation d'exécution (le chat où une exécution planifiée a publié son résultat), la tâche de cette exécution : « mets-la en pause » ou « passe-la à 10 h » y fonctionnent aussi. Cela ne vaut que pour les messages que vous envoyez ; une exécution planifiée ne peut que mettre en pause sa propre planification avec `stop_scheduled_task`.
|
||
- **Une modification garde la tâche.** Changer l'horaire, les instructions, l'objectif, la condition d'arrêt ou le plafond de sécurité est un `update` de la même tâche : son identifiant et son historique sont conservés. `resume` relance une tâche en pause ou terminée, sans exécution de rattrapage. Si le plafond est atteint, l'agent demande comment renouveler la limite épuisée (relever `max_runs` ou le supprimer ; repousser `end_at` ou le supprimer), puis l'envoie avec la reprise.
|
||
- **Fuseau horaire.** Un fuseau que vous nommez l'emporte. Sinon, une nouvelle tâche utilise le fuseau du navigateur que l'application web envoie avec chaque message (`context.client_timezone`, lu uniquement pour cela), et le résultat indique le fuseau retenu. Les intervalles et les heures ponctuelles avec décalage UTC n'en ont pas besoin ; pour un cron ou une heure locale ponctuelle sans fuseau connu (par exemple depuis une messagerie), l'agent pose la question. Une modification garde le fuseau enregistré ; le fuseau du navigateur ne change jamais une tâche existante.
|
||
- **Où apparaissent les résultats.** Chaque exécution publie son résultat dans un nouveau chat intitulé « {tâche} · {heure locale} », ou dans le chat d'origine lorsque la tâche s'y exécute. Quand le planning est mis en pause par l'agent, mis en pause automatiquement ou se termine, le chat d'origine affiche une ligne à l'endroit où en était la conversation, avec un lien vers cette exécution ou vers la tâche ; rien d'autre n'y est renvoyé. La ligne reste après la suppression de la tâche. Le chat d'exécution affiche les instructions de la tâche dans un bloc replié « Instructions de la tâche » sous l'en-tête de l'exécution.
|
||
- **Langue.** L'agent rédige le titre, les instructions et la condition d'arrêt dans votre langue, et les exécutions planifiées répondent dans la langue des instructions.
|
||
- **Essai.** Demandez-le directement, par exemple « Run it now » ou « 先跑一次吧 » ; le bouton **Run once now** de la carte fait de même. Un simple « yes », une mention de la tâche ou une demande citée ou conditionnelle ne lance pas d'exécution payante. Un essai ne compte pas dans `max_runs`.
|
||
|
||
## Atelier terminal (TUI)
|
||
|
||
`deerflow` est un atelier natif terminal pour ceux qui vivent dans le shell. Il s'exécute de manière **intégrée** sur `DeerFlowClient` — pas besoin de Gateway, de frontend, de nginx ou de Docker — tout en honorant les mêmes `config.yaml`, checkpointer, skills, mémoire, MCP et sandbox que le reste de DeerFlow.
|
||
|
||

|
||
|
||
```bash
|
||
uv pip install 'deerflow-harness[tui]' # dépendance optionnelle 'textual'
|
||
|
||
deerflow # lancer l'UI terminal (TTY requis)
|
||
deerflow --continue # reprendre le thread le plus récent
|
||
deerflow --resume THREAD # reprendre un thread par id
|
||
deerflow --print "summarize this repo" # réponse one-shot headless vers stdout
|
||
deerflow --json "hello" # StreamEvents séparés par saut de ligne en mode headless
|
||
```
|
||
|
||
Une surface de chat pilotée au clavier avec un transcript en streaming (réponses rendues en Markdown), des cartes d'activité d'outils compactes, une palette de commandes slash `/`, la gestion des goal via `/goal`, des sélecteurs `/model` et `/threads`, l'historique de saisie, et l'interruption via `Esc` / `Ctrl+C`. Les sessions ouvertes dans le TUI apparaissent aussi dans la barre latérale du Web UI — elles écrivent dans le magasin de threads partagé sous l'utilisateur local par défaut, donc le terminal et le web restent synchronisés **sans lancer la Gateway**.
|
||
|
||
Voir [backend/docs/TUI.md](backend/docs/TUI.md) pour le guide complet.
|
||
|
||
## Documentation
|
||
|
||
- [Guide de contribution](CONTRIBUTING.md) - Mise en place de l'environnement de développement et workflow
|
||
- [Guide de configuration](backend/docs/CONFIGURATION.md) - Instructions d'installation et de configuration
|
||
- [Vue d'ensemble de l'architecture](backend/CLAUDE.md) - Détails de l'architecture technique
|
||
- [Architecture backend](backend/README.md) - Architecture backend et référence API
|
||
|
||
## ⚠️ Avertissement de sécurité
|
||
|
||
### Un déploiement inapproprié peut introduire des risques de sécurité
|
||
|
||
DeerFlow dispose de capacités clés à hauts privilèges, notamment **l'exécution de commandes système, les opérations sur les ressources et l'invocation de logique métier**. Il est conçu par défaut pour être **déployé dans un environnement local de confiance (accessible uniquement via l'interface de loopback 127.0.0.1)**. Si vous déployez l'agent dans des environnements non fiables — tels que des réseaux LAN, des serveurs cloud publics ou d'autres environnements accessibles depuis plusieurs terminaux — sans mesures de sécurité strictes, cela peut introduire des risques, notamment :
|
||
|
||
- **Invocation non autorisée** : les fonctionnalités de l'agent pourraient être découvertes par des tiers non autorisés ou des scanners malveillants, déclenchant des requêtes non autorisées en masse qui exécutent des opérations à haut risque (commandes système, lecture/écriture de fichiers), pouvant causer de graves conséquences.
|
||
- **Risques juridiques et de conformité** : si l'agent est utilisé illégalement pour mener des cyberattaques, du vol de données ou d'autres activités illicites, cela peut entraîner des responsabilités juridiques et des risques de conformité.
|
||
|
||
### Recommandations de sécurité
|
||
|
||
**Note : nous recommandons fortement de déployer DeerFlow dans un environnement réseau local de confiance.** Si vous avez besoin d'un déploiement multi-appareils ou multi-réseaux, vous devez mettre en place des mesures de sécurité strictes, par exemple :
|
||
|
||
- **Liste blanche d'IP** : utilisez `iptables`, ou déployez des pare-feux matériels / commutateurs avec ACL, pour **configurer des règles de liste blanche d'IP** et refuser l'accès à toutes les autres adresses IP.
|
||
- **Passerelle d'authentification** : configurez un proxy inverse (ex. nginx) et **activez une authentification forte en amont**, bloquant tout accès non authentifié.
|
||
- **Isolation réseau** : si possible, placez l'agent et les appareils de confiance dans le **même VLAN dédié**, isolé des autres équipements réseau.
|
||
- **Restez informé** : continuez à suivre les mises à jour de sécurité du projet DeerFlow.
|
||
|
||
## Contribuer
|
||
|
||
Les contributions sont les bienvenues ! Consultez [CONTRIBUTING.md](CONTRIBUTING.md) pour la mise en place de l'environnement de développement, le workflow et les conventions.
|
||
|
||
La couverture de tests de régression inclut la détection du mode sandbox Docker et les tests de gestion du kubeconfig-path du provisioner dans `backend/tests/`.
|
||
|
||
## Licence
|
||
|
||
Ce projet est open source et disponible sous la [Licence MIT](./LICENSE).
|
||
|
||
## Remerciements
|
||
|
||
DeerFlow est construit sur le travail remarquable de la communauté open source. Nous sommes profondément reconnaissants envers tous les projets et contributeurs dont les efforts ont rendu DeerFlow possible. Nous nous tenons véritablement sur les épaules de géants.
|
||
|
||
Nous tenons à exprimer notre sincère gratitude aux projets suivants pour leurs contributions inestimables :
|
||
|
||
- **[LangChain](https://github.com/langchain-ai/langchain)** : leur excellent framework propulse nos interactions LLM et nos chaînes, permettant une intégration et des fonctionnalités fluides.
|
||
- **[LangGraph](https://github.com/langchain-ai/langgraph)** : leur approche innovante de l'orchestration multi-agents a été déterminante pour les workflows sophistiqués de DeerFlow.
|
||
|
||
Ces projets illustrent le pouvoir transformateur de la collaboration open source, et nous sommes fiers de bâtir sur leurs fondations.
|
||
|
||
### Contributeurs principaux
|
||
|
||
Un grand merci aux auteurs principaux de `DeerFlow`, dont la vision, la passion et le dévouement ont donné vie à ce projet :
|
||
|
||
- **[Daniel Walnut](https://github.com/hetaoBackend/)**
|
||
- **[Henry Li](https://github.com/magiccube/)**
|
||
|
||
Votre engagement sans faille et votre expertise sont le moteur du succès de DeerFlow. Nous sommes honorés de vous avoir à la barre de cette aventure.
|
||
|
||
## Star History
|
||
|
||
[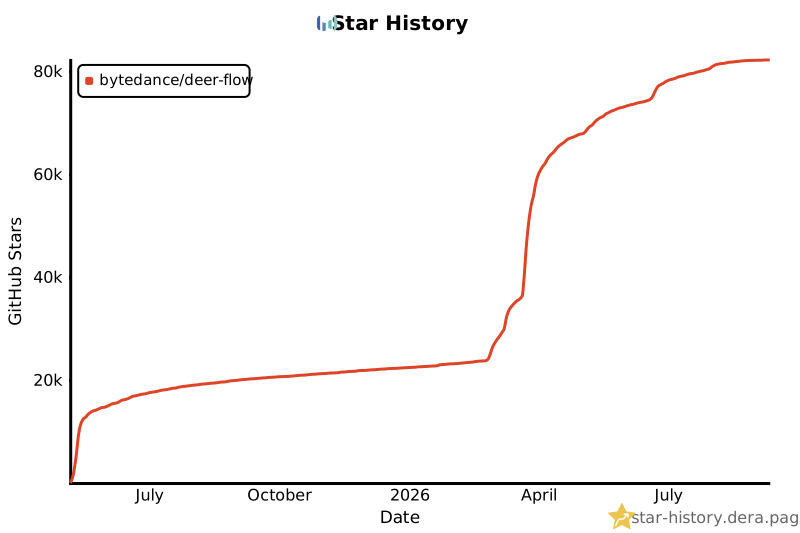](https://star-history.dera.page/#bytedance/deer-flow&Date)
|