 a58ab484a6
* feat(projects): Projects MVP Phase 2 — instructions, document shelf, promotion, trash

Implements docs/superpowers/specs/2026-09-12-projects-mvp-phase2-design.md
(issue #5160, tracker #5129) in the slice order of the spec's §16.

Slices:
- A: ProjectsConfig + write-time 422 UTF-8 byte cap; PROJECT_CONTEXT_KEY
  admission pinning (both server-owned sets + worker hoist); latest-only
  request-scoped <project> block via DynamicContextMiddleware
  wrap_model_call/awrap_model_call (idempotent reassembly, reserved ID
  prefix + marker + provenance, never persisted); journal audit
  fingerprints; Instructions tab.
- B: ProjectDocumentRow + migration 0023; ProjectDocumentRepository with
  locked check-and-set; hash-qualified immutable shelf storage with
  Paths helpers; upload/list/content/delete-to-trash routes; project
  delete trashes the shelf in-transaction; request-scoped bounded
  <documents> index with honest count/shown + actionable overflow note;
  list_project_documents/read_project_document tools registered only on
  pinned runs; PAT allowlist + drift guards; blocking-IO anchors.
- C: shared thread-upload ingestion service (uploads router refactored to
  parity); POST from-thread with provenance; attach-to-thread with
  lock-staged copy (archived source allowed); read-only thread-files
  view with per-group truncation reporting.
- D: restore (restored/merged/not_found/no_target/content_missing; no
  file moves), purge (continuous row lock across unlink/delete/commit,
  retryable on FS errors), retention sweep (lazy + startup, 24h orphan
  guard, row-side reconciliation never deletes).
- E: Documents tab (shelf + conversation-files browser, provenance,
  archived banner, content-missing rows), /workspace/trash route,
  sidebar entry, composer attach handoff, i18n (en-US/zh-CN), e2e mocks
  + specs.

Review hardening folded in (10 rounds, all with tests):
- force active shelf content (HTML/XML family) to download; nosniff on
  artifact + content responses; unified unsandboxed-iframe PDF preview
  (fixes the pre-existing Chromium sandbox blank in the artifact viewer)
- scope document trash to the URL project under the document lock
- atomic no-overwrite filename reservation for ALL ingestion (seeded
  claims + os.link commit with suffix retry; same-name re-upload now
  unique-names instead of replacing); hidden staging only, no visible
  placeholders; lease cleanup on setup failure
- serialize conversion under the document lock with post-lock active
  revalidation; drain locked filesystem work on cancellation; preserve
  bytes when an insert's commit state is uncertain (including trashed
  rows)
- original-integrity checks before serving text or cached conversions;
  content_missing surfaced in list responses (UI reads the flag, no
  409-probe); downloads always serve original bytes
- bounded streaming document reads with cached char counts; shelf limits
  declared in middleware release identity
- thread-root confinement for from-thread sources; config fallback
  rejects fractional/infinite values; composer counts staged
  attachments; pending attachments persist until submission or removal;
  in-flight instruction/rename edits survive save refetches; shelf and
  trash pagination; conversation-file and thread-files pages stay
  subscribed to refetches

Docs: README/README_zh, backend API.md/ARCHITECTURE.md, AGENTS.md
contracts, config.example.yaml projects block.

Review follow-ups (head b4807477 → this revision):
- The trash retention sweep is split so repeated lazy triggers stay
  bounded: the indexed expiry purge still runs on every trigger
  (GET /api/trash/documents, POST /api/trash/purge) while the
  O(all rows + all files) reconciliation is throttled to one run per
  user per 15 minutes (process-local, per-user window). The startup
  sweep now runs as a background task instead of blocking gateway
  readiness, and shutdown awaits it (bounded).
- The export scrub (stripInternalMarkers) is fence- and indentation-aware
  like the render path, so a pasted, fenced <project>/<documents> snippet
  survives markdown export while real injected blocks (never fenced) are
  still removed. Fence regexes moved to a dependency-free leaf module to
  avoid the messages↔streamdown import cycle.
- The artifact viewer's PDF iframe no longer carries an added title
  attribute (the upstream e2e contract locates it via :not([title])), and
  the upstream artifact-preview spec now pins the new contract: PDFs
  render unsandboxed, images keep sandbox="".

* fix(projects): round-2 review — cancel an overrun trash sweep, restore the PDF frame title

- Shutdown cancelled only the shield around the background startup sweep,
  so an all-users reconciliation that outlived the 5s budget kept walking
  rows and files while the document repo and DB engine were disposed
  underneath it. The wait now lives in `_shutdown_startup_trash_sweep`,
  which cancels the task and drains it before worker exit: the shield
  keeps the wait bounded, the cancel makes it final (CancelledError lands
  at the sweep's next await, and `_run_startup_trash_sweep` only catches
  `Exception`, so nothing swallows it).
- The browser-preview iframe lost `title={getFileName(filepath)}` in the
  previous fix round, leaving the PDF frame without an accessible name
  while its siblings keep theirs. Restore it (WCAG frame titles), assert
  it in the DOM test, and anchor the e2e on `iframe[title="report.pdf"]`
  instead of `iframe:not([title])`.

* fix(projects): round-3 review — report the sweep's late finish, not a phantom cancel

`Task.cancel()` returns False when the sweep already finished inside the
window between the deadline firing and the cancel, so the shutdown log
claimed a cancellation that never happened. Branch on that outcome: the
warning stays for a real cancel, a late finish is logged at info, and both
paths still reap the task before worker exit.

* fix(projects): round-4 review — make Empty trash delete what it confirms

`POST /api/trash/purge` only ran the retention sweep, and the sweep's
candidate selection is age-gated, so a freshly trashed document survived
"Empty trash" even though the confirmation promises that every listed
document is permanently deleted. With one trashed row the route answered
`{"purged": 0}` and left it in place; `GET /api/trash/documents` sweeps
expired rows before listing, so the visible rows were normally ineligible
for the action by construction.

Empty trash now drives `purge_all_trashed`: the caller's trashed rows
(`list_all_trashed`, no age filter) each go through the same guarded,
row-locked `purge` as the single-document delete — bytes first, then the
row, in one transaction — so a row restored mid-flight is skipped instead of
force-deleted, and an unlink failure rolls that row back and answers 500 with
a retryable message. Retention expiry stays where it was: the sweep's
`purge_candidates` is now the only age-gated selection, and the lazy
retention sweep still runs on the listing and at startup.

Tests: the router suite replaces the retention-gated expectation with the
reviewer's repro (fresh row purged, bytes unlinked, shelf and other users'
trash untouched, a failing unlink stays retryable and 500); a blocking-I/O
anchor drives the new entry point through the offload; the mocked e2e covers
the action end to end; a new real-backend spec performs it against the real
gateway and re-reads `GET /api/trash/documents`. README, API, ARCHITECTURE
and the phase-2 design docs (en+zh) state the age-independent contract.
66 KiB
🦌 DeerFlow - 2.0
English | 中文 | 日本語 | Français | Русский

2026 年 2 月 28 日,DeerFlow 2 发布后登上 GitHub Trending 第 1 名。非常感谢社区的支持,这是大家一起做到的。
DeerFlow(Deep Exploration and Efficient Research Flow)是一个开源的 super agent harness。它把 sub-agents、memory 和 sandbox 组织在一起,再配合可扩展的 skills,让 agent 可以完成几乎任何事情。
https://github.com/user-attachments/assets/a8bcadc4-e040-4cf2-8fda-dd768b999c18
Note
DeerFlow 2.0 是一次彻底重写。 它和 v1 没有共用代码。如果你要找的是最初的 Deep Research 框架,可以前往
1.x分支。那里仍然欢迎贡献;当前的主要开发已经转向 2.0。
官网
想了解更多,或者直接看真实演示,可以访问官网。
姐妹项目
- LLM Space - 认识 DeerFlow 背后的秘密武器——一款桌面工具,用于原型化 agent 想法、检查 harness 的每个步骤、回放失败用例并基准测试性能。
字节跳动火山引擎方舟 Coding Plan
- 我们推荐使用 Doubao-Seed-2.0-Code、DeepSeek v3.2 和 Kimi 2.5 运行 DeerFlow
- 现在就加入 Coding Plan
- 海外地区的开发者请点击这里
InfoQuest
DeerFlow 新近集成了 BytePlus 自研的智能搜索与抓取工具集——InfoQuest(支持免费在线体验)
目录
- 🦌 DeerFlow - 2.0
一句话交给 Coding Agent 安装
如果你在用 Claude Code、Codex、Cursor、Windsurf 或其他 coding agent,可以直接把下面这句话发给它:
如果还没 clone DeerFlow,就先 clone,然后按照 https://raw.githubusercontent.com/bytedance/deer-flow/main/Install.md 把它的本地开发环境初始化好
这条提示词是给 coding agent 用的。它会在需要时先 clone 仓库,优先选择 Docker,完成初始化,并在结束时告诉你下一条启动命令,以及还缺哪些配置需要你补充。
快速开始
配置
-
克隆 DeerFlow 仓库
git clone https://github.com/bytedance/deer-flow.git cd deer-flow -
运行安装向导(推荐)
在项目根目录(
deer-flow/)执行:make setup这会启动一个交互式向导,引导你选择 LLM provider、可选的 web 搜索工具,以及 sandbox 模式、bash 权限、文件写入等执行/安全偏好。它会生成一份最小化的
config.yaml,并把 API key 写入.env,大约 2 分钟完成。随时可以运行
make doctor检查配置和系统环境,并获得可执行的修复建议。 如果你要提交本地安装、配置或运行问题,可以执行make support-bundle。 命令会直接打印 reporter 下一步建议,并在.deer-flow/support-bundles/下生成*-issue-summary.md、面向 AI 辅助提 issue 的*-issue-draft.md,以及可选证据 zip。提交 GitHub issue 时,先把*-issue-summary.md粘贴到 issue 正文;如果由 AI 助手代填 issue,就从*-issue-draft.md开始,并先替换所有 REQUIRED 占位符, 不要编造未知事实。只有维护者要求证据包,或摘要不足以诊断时,再附上 zip。维护者 或 AI 辅助 triage 可以优先读取triage.json;bundle 只包含脱敏后的诊断信息和 文件 manifest,不包含.env、原始对话消息或用户文件内容;提交前仍建议自己快速 检查一遍。进阶 / 手动配置:如果你更想直接编辑
config.yaml,可以改用make config复制完整的示例模板。完整参考见config.example.yaml,其中包含 CLI-backed provider(Codex CLI、Claude Code OAuth)、OpenRouter、Responses API 等更多配置。手动模型配置示例
models:
  - name: gpt-4o
    display_name: GPT-4o
    use: langchain_openai:ChatOpenAI
    model: gpt-4o
    api_key: $OPENAI_API_KEY

  - name: openrouter-gemini-2.5-flash
    display_name: Gemini 2.5 Flash (OpenRouter)
    use: langchain_openai:ChatOpenAI
    model: google/gemini-2.5-flash-preview
    api_key: $OPENROUTER_API_KEY
    base_url: https://openrouter.ai/api/v1

  - name: gpt-5-responses
    display_name: GPT-5 (Responses API)
    use: langchain_openai:ChatOpenAI
    model: gpt-5
    api_key: $OPENAI_API_KEY
    use_responses_api: true
    output_version: responses/v1

  - name: qwen3-32b-vllm
    display_name: Qwen3 32B (vLLM)
    use: deerflow.models.vllm_provider:VllmChatModel
    model: Qwen/Qwen3-32B
    api_key: $VLLM_API_KEY
    base_url: http://localhost:8000/v1
    supports_thinking: true
    when_thinking_enabled:
      extra_body:
        chat_template_kwargs:
          enable_thinking: true
OpenRouter 以及类似的 OpenAI 兼容网关,建议通过
langchain_openai:ChatOpenAI配合base_url来配置。如果你更想用 provider 自己的环境变量名,也可以直接把api_key指向对应变量,例如api_key: $OPENROUTER_API_KEY。如果要让 OpenAI 模型走
/v1/responses,继续使用langchain_openai:ChatOpenAI,并设置use_responses_api: true和output_version: responses/v1。Setup Wizard 已内置 Z.AI GLM-5.3-Flash 配置。由于该模型强制开启 thinking,且只接受自身限定的 effort 档位,当前兼容配置会在前台和后台调用中始终保持 thinking 开启,并暂时屏蔽 DeerFlow 的通用 effort 选择器。等价的手动配置见
config.example.yaml。对于 vLLM 0.19.0,请使用
deerflow.models.vllm_provider:VllmChatModel。对于 Qwen 风格的推理模型,DeerFlow 通过extra_body.chat_template_kwargs.enable_thinking开关推理,并在多轮 tool-call 对话中保留 vLLM 非标准的reasoning字段。旧版thinking配置会自动规范化以保持向后兼容。推理模型可能还需要在启动 vLLM 服务时加上--reasoning-parser ...参数。如果你的本地 vLLM 部署接受任意非空 API key,可以把VLLM_API_KEY设为一个占位值。CLI-backed provider 配置示例:
models: - name: gpt-5.4 display_name: GPT-5.4 (Codex CLI) use: deerflow.models.openai_codex_provider:CodexChatModel model: gpt-5.4 supports_thinking: true supports_reasoning_effort: true - name: claude-sonnet-4.6 display_name: Claude Sonnet 4.6 (Claude Code OAuth) use: deerflow.models.claude_provider:ClaudeChatModel model: claude-sonnet-4-6 max_tokens: 4096 supports_thinking: true- Codex CLI 会读取
~/.codex/auth.json - Claude Code 支持
CLAUDE_CODE_OAUTH_TOKEN、ANTHROPIC_AUTH_TOKEN、CLAUDE_CODE_CREDENTIALS_PATH,或~/.claude/.credentials.json - ACP agent 条目与 model provider 是分开配置的——如果你配置了
acp_agents.codex,请把它指向一个 Codex ACP 适配器,例如npx -y @zed-industries/codex-acp - MiniMax Code 原生支持 ACP,不需要额外适配器。先安装并登录,再把它配置成 ACP agent:
npm install --global @minimax-ai/code mcode loginacp_agents: mcode: command: mcode args: ["acp"] description: MiniMax Code for implementation, refactoring, debugging, and repository tasks auto_approve_permissions: falsemcode必须位于 Gateway 进程的PATH中;只安装在 Docker host 上并不会让 Gateway 容器内可用。DeerFlow 会通过invoke_acp_agent在每个 thread 独立的 ACP workspace 中调用 MCode,并转发已启用的 MCP server。处理不可信任务时请保持auto_approve_permissions: false;只有在任务可信且确实需要 MCode 修改文件或执行命令时才启用它。- 在 macOS 上,如有需要可显式导出 Claude Code 的认证信息:
eval "$(python3 scripts/export_claude_code_oauth.py --print-export)"API key 也可以手动写入
.env文件(推荐)或在 shell 中导出:OPENAI_API_KEY=your-openai-api-key TAVILY_API_KEY=your-tavily-api-key - Codex CLI 会读取
运行应用
部署建议与资源规划
可以先按下面的资源档位来选择 DeerFlow 的运行方式:
| 部署场景 | 起步配置 | 推荐配置 | 说明 |
|---|---|---|---|
本地体验 / make dev |
4 vCPU、8 GB 内存、20 GB SSD 可用空间 | 8 vCPU、16 GB 内存 | 适合单个开发者或单个轻量会话,且模型走外部 API。2 核 / 4 GB 通常跑不稳。 |
Docker 开发 / make docker-start |
4 vCPU、8 GB 内存、25 GB SSD 可用空间 | 8 vCPU、16 GB 内存 | 镜像构建、源码挂载和 sandbox 容器都会比纯本地模式更吃资源。 |
长期运行服务 / make up |
8 vCPU、16 GB 内存、40 GB SSD 可用空间 | 16 vCPU、32 GB 内存 | 更适合共享环境、多 agent 任务、报告生成或更重的 sandbox 负载。 |
- 上面的配置只覆盖 DeerFlow 本身;如果你还要本机部署本地大模型,请单独为模型服务预留资源。
- 持续运行的服务更推荐使用 Linux + Docker。macOS 和 Windows 更适合作为开发机或体验环境。
- 如果 CPU 或内存长期打满,先降低并发会话或重任务数量,再考虑升级到更高一档配置。
方式一:Docker(推荐)
需要 Docker Desktop / Docker Engine,以及 Docker Compose v2.24+
(docker compose version)。更旧的 Compose 客户端无法解析
docker/docker-compose-dev.yaml 里的可选 env_file 语法。
开发模式(支持热更新,挂载源码):
make docker-init    # 拉取 sandbox 镜像(首次运行或镜像更新时执行)
make docker-start   # 启动服务(会根据 config.yaml 自动判断 sandbox 模式)
如果 config.yaml 使用的是 provisioner 模式(sandbox.use: deerflow.community.aio_sandbox:AioSandboxProvider 且配置了 provisioner_url),make docker-start 才会启动 provisioner。
生产模式(本地构建镜像,并挂载运行期配置与数据):
make up     # 构建镜像并启动全部生产服务
make down   # 停止并移除容器
Note
当前 Agent 运行时嵌入在 Gateway 中运行,
/api/langgraph/*会由 nginx 重写到 Gateway 的 LangGraph-compatible API。
更完整的 Docker 开发说明见 CONTRIBUTING.md。
方式二:本地开发
如果你更希望直接在本地启动各个服务:
前提:先完成上面的“配置”步骤(make setup)。make dev 需要有效配置文件,默认读取项目根目录下的 config.yaml。可以用 DEER_FLOW_PROJECT_ROOT 显式指定项目根目录,也可以用 DEER_FLOW_CONFIG_PATH 指向某个具体配置文件。运行期状态默认写到项目根目录下的 .deer-flow,可用 DEER_FLOW_HOME 覆盖;skills 默认读取项目根目录下的 skills/,可用 DEER_FLOW_SKILLS_PATH 覆盖。启动前先运行 make doctor 校验配置。
在 Windows 上,请使用 Git Bash 运行本地开发流程。基于 bash 的服务脚本不支持直接在原生 cmd.exe 或 PowerShell 中执行,且 WSL 也不保证可用,因为部分脚本依赖 Git for Windows 的 cygpath 等工具。
-
检查依赖环境:
make check # 校验 Node.js 22+、pnpm、uv、nginx -
安装依赖:
make install # 安装 backend + frontend 依赖 -
(可选)预拉取 sandbox 镜像:
# 如果使用 Docker / Container sandbox,建议先执行 make setup-sandbox -
启动服务:
make dev
LangGraph Studio(可选)
默认的 make dev 拓扑使用 DeerFlow 内嵌于 Gateway 的运行时,无需 LangGraph Studio。
如需用独立开发服务器检查和测试已注册的 lead-agent 图,请在 backend/ 目录下运行
以下命令,以便 CLI 发现 langgraph.json:
cd backend
uv run langgraph dev --allow-blocking
该命令会打印本地 API 与 Studio UI 地址。这个内存态服务器仅用于开发与测试;
该标志允许 DeerFlow 在处理本地 Studio 请求时执行同步的配置加载与图工厂初始化,
不能当作生产服务器设置使用。本地 Studio 的认证会自动处理,连接无需自定义请求头。
生产负载请使用 DeerFlow 文档中的生产启动模式或受支持的 LangSmith 部署。在这种
独立模式下,assistant 的归属与来源由服务器管理:Studio 可以发现已注册的图及其
创建的 assistants,正常的 assistant 版本选择依然可用。在锁定态本地运行时加载其
持久化开发存储之前,DeerFlow 会修复历史遗留的 assistant 行与版本历史,防止历史
客户端元数据恢复服务器权限,或被运行时的启动清理流程丢弃。请用 uv sync 保持
后端依赖同步;该兼容路径依赖已声明的 LangGraph 运行时版本,若持久化存储契约
与预期不再匹配会记录警告。文档中的命令使用 LangGraph 基于文件的自定义应用加载器,
DeerFlow 的回归测试也直接覆盖了它。
对通过 LangGraph Studio 或直连 LangGraph Server 调用 backend/langgraph.json
的工作流,DeerFlow 会消费该运行时发布的已认证身份,并将其用于 custom-agent
配置/SOUL、用户技能与技能策略、上传、线程数据以及记忆读写。这使经过认证的运行
不会落入共享的 default 文件系统桶,且服务器管理的身份优先于普通客户端提供的
user_id 值。诸如邮箱地址之类的外部身份会在访问 DeerFlow 存储前,被映射为稳定、
抗碰撞且目录安全的用户 ID。默认的 DeerFlow 服务拓扑仍是上文描述的 Gateway 内嵌
运行时。
Gateway 运行时会自动强制对 /mnt/user-data/outputs 下创建或修改的产物执行原生交付:present_files 必须至少展示一个由当前运行产出的输出,且终止时的 run.delivery 回执必须被持久化记录。虚拟产物路径会在产出该输出的同一已认证用户与线程范围内解析,然后再校验输出目录边界。未产出产物文件的运行保持普通对话行为。
DeerFlow 的内置自定义事件同时通过两种 LangGraph 流式接口提供:原生客户端可以继续订阅 stream_mode="custom",基于回调的集成则可以从 astream_events(version="v2") 以 on_custom_event 记录的形式消费相同载荷。回调事件名与载荷的 type 字段一致。
进阶配置
Sandbox 模式
DeerFlow 支持多种 sandbox 执行方式:
- 本地执行(直接在宿主机上运行 sandbox 代码)
- Docker 执行(在隔离的 Docker 容器里运行 sandbox 代码)
- Docker + Kubernetes 执行(通过 provisioner 服务在 Kubernetes Pod 中运行 sandbox 代码)
Docker 开发时,服务启动行为会遵循 config.yaml 里的 sandbox 模式。在 Local / Docker 模式下,不会启动 provisioner。
如果要配置你自己的模式,参见 Sandbox 配置指南。
MCP Server
DeerFlow 支持可配置的 MCP Server 和 skills,用来扩展能力。
对于 HTTP/SSE MCP Server,还支持 OAuth token 流程(client_credentials、refresh_token)。
详细说明见 MCP Server 指南。
IM 渠道
DeerFlow 支持从即时通讯应用接收任务。只要配置完成,对应渠道会自动启动,而且都不需要公网 IP。
DeerFlow 还可以在 workspace UI 里暴露用户自有的 IM 渠道连接。启用 channel_connections 后,已登录用户可以从侧边栏 / Settings > Channels 绑定 Telegram、Slack、Discord、Feishu/Lark、DingTalk、WeChat 或 WeCom。它复用现有的 channels.* 出站传输,因此不需要公网 IP 或 provider 回调地址。入站 IM 消息会以所连接的 DeerFlow 用户身份运行。设置和安全注意事项参见 IM Channel Connections。
| 渠道 | 传输方式 | 上手难度 |
|---|---|---|
| Telegram | Bot API(long-polling) | 简单 |
| Slack | Socket Mode | 中等 |
| Feishu / Lark | WebSocket | 中等 |
| Tencent iLink(long-polling) | 中等 | |
| 企业微信智能机器人 | WebSocket | 中等 |
| 钉钉 | Stream Push(WebSocket) | 中等 |
config.yaml 中的配置示例:
channels:
  # LangGraph-compatible Gateway API base URL(默认:http://localhost:8001/api)
  langgraph_url: http://localhost:8001/api
  # Gateway API URL(默认:http://localhost:8001)
  gateway_url: http://localhost:8001

  # 可选:所有移动端渠道共用的全局 session 默认值
  session:
    assistant_id: lead_agent  # 也可以填自定义 agent 名;渠道层会自动转换为 lead_agent + agent_name
    config:
      recursion_limit: 100
    context:
      thinking_enabled: true
      is_plan_mode: false
      subagent_enabled: false

  feishu:
    enabled: true
    app_id: $FEISHU_APP_ID
    app_secret: $FEISHU_APP_SECRET
    # domain: https://open.feishu.cn       # 国内版(默认)
    # domain: https://open.larksuite.com   # 国际版

  wecom:
    enabled: true
    bot_id: $WECOM_BOT_ID
    bot_secret: $WECOM_BOT_SECRET

  slack:
    enabled: true
    bot_token: $SLACK_BOT_TOKEN     # xoxb-...
    app_token: $SLACK_APP_TOKEN     # xapp-...(Socket Mode)
    allowed_users: []               # 留空表示允许所有人

  telegram:
    enabled: true
    bot_token: $TELEGRAM_BOT_TOKEN
    allowed_users: []               # 留空表示允许所有人

    # 可选:按渠道 / 按用户单独覆盖 session 配置
    session:
      assistant_id: mobile-agent  # 这里同样支持自定义 agent 名
      context:
        thinking_enabled: false
      users:
        "123456789":
          assistant_id: vip-agent
          config:
            recursion_limit: 150
          context:
            thinking_enabled: true
            subagent_enabled: true

  wechat:
    enabled: false
    bot_token: $WECHAT_BOT_TOKEN
    ilink_bot_id: $WECHAT_ILINK_BOT_ID
    qrcode_login_enabled: true      # 可选:bot_token 缺失时允许首次扫码登录引导
    allowed_users: []               # 留空表示允许所有人
    polling_timeout: 35
    state_dir: ./.deer-flow/wechat/state
    max_inbound_image_bytes: 20971520
    max_outbound_image_bytes: 20971520
    max_inbound_file_bytes: 52428800
    max_outbound_file_bytes: 52428800

  dingtalk:
    enabled: true
    client_id: $DINGTALK_CLIENT_ID             # 钉钉开放平台 ClientId
    client_secret: $DINGTALK_CLIENT_SECRET     # 钉钉开放平台 ClientSecret
    allowed_users: []                          # 留空表示允许所有人
    card_template_id: ""                       # 可选:AI 卡片模板 ID,用于流式打字机效果
说明:
assistant_id: lead_agent会直接调用默认的 LangGraph assistant。- 如果
assistant_id填的是自定义 agent 名,DeerFlow 仍然会走lead_agent,同时把该值注入为agent_name,这样 IM 渠道也会生效对应 agent 的 SOUL 和配置。
在 .env 里设置对应的 API key:
# Telegram
TELEGRAM_BOT_TOKEN=123456789:ABCdefGHIjklMNOpqrSTUvwxYZ

# Slack
SLACK_BOT_TOKEN=xoxb-...
SLACK_APP_TOKEN=xapp-...

# Feishu / Lark
FEISHU_APP_ID=cli_xxxx
FEISHU_APP_SECRET=your_app_secret

# WeChat iLink
WECHAT_BOT_TOKEN=your_ilink_bot_token
WECHAT_ILINK_BOT_ID=your_ilink_bot_id

# 企业微信智能机器人
WECOM_BOT_ID=your_bot_id
WECOM_BOT_SECRET=your_bot_secret

# 钉钉
DINGTALK_CLIENT_ID=your_client_id
DINGTALK_CLIENT_SECRET=your_client_secret
Telegram 配置
- 打开 @BotFather,发送
/newbot,复制生成的 HTTP API token。 - 在
.env中设置TELEGRAM_BOT_TOKEN,并在config.yaml里启用该渠道。 - 机器人支持接收入站文本、图片和文档(可带说明文字,也可不带);托管版 Bot API 的单个附件下载上限为 20 MB。
Slack 配置
- 前往 api.slack.com/apps 创建 Slack App:Create New App → From scratch。
- 在 OAuth & Permissions 中添加 Bot Token Scopes:
app_mentions:read、chat:write、im:history、im:read、im:write、files:write。 - 启用 Socket Mode,生成带
connections:write权限的 App-Level Token(xapp-...)。 - 在 Event Subscriptions 中订阅 bot events:
app_mention、message.im。 - 在
.env中设置SLACK_BOT_TOKEN和SLACK_APP_TOKEN,并在config.yaml中启用该渠道。
Feishu / Lark 配置
- 在 飞书开放平台 创建应用,并启用 Bot 能力。
- 添加权限:
im:message、im:message.p2p_msg:readonly、im:resource。 - 在 事件订阅 中订阅
im.message.receive_v1,连接方式选择 长连接。 - 复制 App ID 和 App Secret,在
.env中设置FEISHU_APP_ID和FEISHU_APP_SECRET,并在config.yaml中启用该渠道。
WeChat 配置
- 在
config.yaml中启用wechat渠道。 - 在
.env中设置WECHAT_BOT_TOKEN,或者把qrcode_login_enabled设为true以便首次扫码登录引导。 - 当
bot_token缺失且启用了扫码引导时,留意后端日志里 iLink 返回的二维码内容,并完成绑定流程。 - 扫码流程成功后,DeerFlow 会把获取到的 token 持久化到
state_dir,便于后续重启复用。 - Docker Compose 部署时,请把
state_dir放在持久化卷上,这样get_updates_buf游标和已保存的登录状态才能在重启后保留。
企业微信智能机器人配置
- 在企业微信智能机器人平台创建机器人,获取
bot_id和bot_secret。 - 在
config.yaml中启用channels.wecom,并填入bot_id/bot_secret。 - 在
.env中设置WECOM_BOT_ID和WECOM_BOT_SECRET。 - 安装后端依赖时确保包含
wecom-aibot-python-sdk,渠道会通过 WebSocket 长连接接收消息,无需公网回调地址。 - 当前支持文本、图片和文件入站消息;agent 生成的最终图片/文件也会回传到企业微信会话中。
钉钉配置
- 在 钉钉开放平台 创建应用,并启用 机器人 能力。
- 在机器人配置页面设置消息接收模式为 Stream模式。
- 复制
Client ID和Client Secret,在.env中设置DINGTALK_CLIENT_ID和DINGTALK_CLIENT_SECRET,并在config.yaml中启用该渠道。 - (可选) 如需开启流式 AI 卡片回复(打字机效果),请在钉钉卡片平台创建 AI 卡片模板,然后在
config.yaml中将card_template_id设为该模板 ID。同时需要申请Card.Streaming.Write和Card.Instance.Write权限。
命令
渠道连接完成后,你可以直接在聊天窗口里和 DeerFlow 交互:
| 命令 | 说明 |
|---|---|
/new |
开启新对话 |
/status |
查看当前 thread 信息 |
/models |
列出可用模型 |
/memory |
查看 memory |
/help |
查看帮助 |
没有命令前缀的消息会被当作普通聊天处理。DeerFlow 会自动创建 thread,并以对话方式回复。
请求链路关联
每个 Gateway HTTP 响应都携带 X-Trace-Id 响应头。若调用方传入了入站 X-Trace-Id 则继承之,否则自动生成,代理或上游服务可以借此跨服务固定同一个 id。该行为无需配置,也无法关闭。
同一 id 会附着在生命周期超出 HTTP 响应的工作上:分离出的运行任务、它委派的 subagent,以及后台记忆更新线程。它以 deerflow_trace_id 的形式记录在 run 记录上(runs API 可见)、thread 的 checkpoint 元数据中,以及 Langfuse 追踪里。定时任务、MCP 任务通知运行和 IM 渠道消息不经 HTTP 启动,会为每次出现自行铸造一个 id。
仅当增强日志开启时,日志记录才会携带该 id:
logging:
  enhance:
    enabled: true   # 将 trace_id 打印进日志记录
    format: text    # 或 json
该开关默认关闭,因为开启会改变日志格式。logging 配置需要重启才能生效,所以请编辑 config.yaml 并重启 Gateway。该设置只影响日志输出——id、响应头和运行元数据不受影响。
deerflow_trace_id 是 DeerFlow 的链路关联 id:它不是 run id,也不是 provider 的原生追踪 id,同样不是查询键——没有任何逻辑用它反查 thread 或 run;它只用于关联日志行。在 run 请求的 metadata 或 config.context 中传入的 deerflow_trace_id 会被忽略并覆盖,因此响应头、日志和持久化的运行记录永远不会相互矛盾。要固定关联 id,请发送 X-Trace-Id 请求头。
Gateway 的运行历史还会为每次运行记录一条终止时的 run.delivery 回执,包括零产出与崩溃恢复的运行。正常执行时,该回执会在持久化终止运行状态之前写入。孤儿恢复会先原子地认领过期租约,再幂等地回填回执,因此过期的恢复扫描不会覆盖仍在运行的详细交付事实。在事件存储中断期间,回执持久化保持尽力而为。对 checkpoint 预检失败(或在等待前序 finalization 时被取消)的运行,保持既有的完成数据行为:它们会收到零交付回执,但不会用空快照覆盖 RunStore 的完成字段。
当 tool_progress.enabled 为 true 时,同一份运行事件历史还会记录结果质量防护器的阶段变化。它也会为 lead agent 与普通 task subagent 记录 loop-detection 判定和延迟 MCP 工具晋升。晋升事件会标识新晋升的延迟工具名称,以及是路由元数据还是 tool_search 选中了它们,但不会把搜索查询、路由关键词、schema、参数、结果或目录哈希复制进晋升事件本身。
LangSmith 链路追踪
DeerFlow 内置了 LangSmith 集成,用于可观测性。启用后,所有 LLM 调用、agent 运行和工具执行都会被追踪,并在 LangSmith 仪表盘中展示。
在 .env 文件中添加以下配置:
LANGSMITH_TRACING=true
LANGSMITH_ENDPOINT=https://api.smith.langchain.com
LANGSMITH_API_KEY=lsv2_pt_xxxxxxxxxxxxxxxx
LANGSMITH_PROJECT=xxx
Langfuse 链路追踪
DeerFlow 同样支持 Langfuse 可观测性,适用于兼容 LangChain 的运行。
在 .env 文件中添加以下配置:
LANGFUSE_TRACING=true
LANGFUSE_PUBLIC_KEY=pk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_SECRET_KEY=sk-lf-xxxxxxxxxxxxxxxx
LANGFUSE_BASE_URL=https://cloud.langfuse.com
如果你使用自托管的 Langfuse 实例,请将 LANGFUSE_BASE_URL 设置为你的部署地址。
链路关联字段。 每次 agent 运行都会标注 Langfuse 的保留追踪属性,这样 Sessions 和 Users 页面就能自动填充数据:
session_id= LangGraph 的thread_id——将同一会话的所有 trace 归为一组user_id= 来自get_effective_user_id()的有效用户(在无鉴权模式下回退为default)trace_name= assistant id(默认为lead-agent)tags=[env:<DEER_FLOW_ENV>, model:<model_name>](未设置时省略)metadata.deerflow_trace_id= DeerFlow 的请求关联 id,始终与同一请求返回的X-Trace-Id响应头一致(logging.enhance.enabled只控制该 id 是否打印到日志中)
这些字段会在图(graph)调用的根部注入到 RunnableConfig.metadata,同时覆盖 gateway 路径(runtime/runs/worker.py::run_agent)和内嵌路径(client.py::DeerFlowClient.stream),因此任何兼容 LangChain 的 callback 都能读取到它们。设置 DEER_FLOW_ENV(或 ENVIRONMENT)可按部署环境为 trace 打标签。
同时使用两种追踪服务
如果同时启用 LangSmith 和 Langfuse,DeerFlow 会挂载两个追踪 callback,并将相同的模型活动上报到两个系统。
如果某个 provider 被显式启用但缺少必要的凭据,或其 callback 初始化失败,DeerFlow 会在创建模型、初始化追踪时快速失败(fail fast),错误信息会指明导致失败的 provider。
Docker 部署时,追踪默认关闭。在 .env 中设置 LANGSMITH_TRACING=true 和 LANGSMITH_API_KEY 即可启用。
从 Deep Research 到 Super Agent Harness
DeerFlow 最初是一个 Deep Research 框架,后来社区把它一路推到了更远的地方。上线之后,开发者拿它去做的事情早就不止研究:搭数据流水线、生成演示文稿、快速起 dashboard、自动化内容流程,很多方向一开始连我们自己都没想到。
这让我们意识到一件事:DeerFlow 不只是一个研究工具。它更像一个 harness,一个真正让 agents 把事情做完的运行时基础设施。
所以我们把它从头重做了一遍。
DeerFlow 2.0 不再是一个需要你自己拼装的 framework。它是一个开箱即用、同时又足够可扩展的 super agent harness。基于 LangGraph 和 LangChain 构建,默认就带上了 agent 真正会用到的关键能力:文件系统、memory、skills、sandbox 执行环境,以及为复杂多步骤任务做规划、拉起 sub-agents 的能力。
你可以直接拿来用,也可以拆开重组,改成你自己的样子。
核心特性
Skills 与 Tools
Skills 是 DeerFlow 能做“几乎任何事”的关键。
标准的 Agent Skill 是一种结构化能力模块,通常就是一个 Markdown 文件,里面定义了工作流、最佳实践,以及相关的参考资源。DeerFlow 自带一批内置 skills,覆盖研究、报告生成、演示文稿制作、网页生成、图像和视频生成等场景。真正有意思的地方在于它的扩展性:你可以加自己的 skills,替换内置 skills,或者把多个 skills 组合成复合工作流。
Skills 采用按需渐进加载,不会一次性把所有内容都塞进上下文。只有任务确实需要时才加载,这样能把上下文窗口控制得更干净,也更适合对 token 比较敏感的模型。
通过 Gateway 安装 .skill 压缩包时,DeerFlow 会接受标准的可选 frontmatter 元数据,比如 version、author、compatibility,不会把本来合法的外部 skill 拒之门外。
Tools 也是同样的思路。DeerFlow 自带一组核心工具:网页搜索、网页抓取、网页渲染截图、文件操作、bash 执行;同时也支持通过 MCP Server 和 Python 函数扩展自定义工具。你可以替换任何一项,也可以继续往里加。
Gateway 生成后续建议时,现在会先把普通字符串输出和 block/list 风格的富文本内容统一归一化,再去解析 JSON 数组响应,因此不同 provider 的内容包装方式不会再悄悄把建议吞掉。
Web UI 支持从已完成的 assistant 回复分叉出一个新的主对话。自动继承的分叉标题会使用下一个空闲的数字后缀(标题 (2)、标题 (3)……);显式指定或手动重命名得到的同名后缀也会占号,即使它没有生成序号 metadata,后续自动分叉也不会与它重名。API 调用方显式提供的标题保持不变;重命名会清除旧的生成序号,因此从新标题继续自动分叉时会重新从 (2) 开始。最近对话列表还会把已加载的分叉直接排列在已加载的父对话下方,并显示低干扰的树形连接线。父对话尚未加载、谱系数据错误或成环、父子置顶状态不一致时,分叉会安全地保留在顶层,不会被隐藏或跨越置顶边界移动。新 thread 会保留该轮回复的 checkpoint 以及用户消息之前的重放 checkpoint,因此分叉后可以立即重新生成该回复。对于缺少 checkpoint 父链接的旧历史或导入历史,Gateway 会进行有界的时间顺序查找;如果不存在更早的重放 checkpoint,分叉仍会按旧版单-checkpoint 形态成功创建,但无法重新生成继承的回复。已有的单-checkpoint 分叉会保持不变,不会通过不安全的 checkpoint 复制尝试修复。只有从最新回合分叉时才会尽力复制当前 thread 的工作区文件;从历史回合分叉不会带入后续时间线创建的文件。
# sandbox 容器内的路径
/mnt/skills/public
├── research/SKILL.md
├── report-generation/SKILL.md
├── slide-creation/SKILL.md
├── web-page/SKILL.md
└── image-generation/SKILL.md

/mnt/skills/custom
└── your-custom-skill/SKILL.md      ← 你的 skill
Claude Code 集成
借助 claude-to-deerflow skill,你可以直接在 Claude Code 里和正在运行的 DeerFlow 实例交互。不用离开终端,就能下发研究任务、查看状态、管理 threads。
安装这个 skill:
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
然后确认 DeerFlow 已经启动(默认地址是 http://localhost:2026),在 Claude Code 里使用 /claude-to-deerflow 命令即可。
你可以做的事情包括:
- 给 DeerFlow 发送消息,并接收流式响应
- 选择执行模式:flash(更快)、standard、pro(规划模式)、ultra(sub-agents 模式)
- 检查 DeerFlow 健康状态,列出 models / skills / agents
- 管理 threads 和会话历史
- 上传文件做分析
环境变量(可选,用于自定义端点):
DEERFLOW_URL=http://localhost:2026            # 统一代理基地址
DEERFLOW_GATEWAY_URL=http://localhost:2026    # Gateway API
DEERFLOW_LANGGRAPH_URL=http://localhost:2026/api/langgraph  # LangGraph API
完整 API 说明见 skills/public/claude-to-deerflow/SKILL.md。
Web UI 输入框支持浏览器侧语音听写。浏览器提供 Web Speech API 时,麦克风按钮会把语音转写为本地草稿;DeerFlow 只接收转写后的文本,音频处理交由浏览器或操作系统语音识别服务按其环境策略完成。用户可以在发送前继续检查和编辑文本。
会话归档
在侧栏最近会话的菜单中点击「归档」,可以隐藏已完成的会话,同时保留消息、文件和原链接。成功提示提供「撤销」。在「对话 → 已归档」中查看并逐条恢复;已打开的归档会话也会在顶部显示恢复入口。搜索匹配已加载会话的标题,较早记录可通过「加载更多」查找。
归档与恢复保留会话原有的活动时间和置顶状态。归档不会停止运行中的任务或暂停定时任务,新消息也不会自动恢复会话。需要移除会话及其文件时,使用原有的删除操作。
Session Goals
用 /goal <完成条件> 为当前 thread 绑定一个激活态的完成条件。这个 goal 是 thread 维度的状态,而不是技能激活,所以它会跨轮次持续生效,直到 DeerFlow 判定它已被满足、或者你手动清除它。
支持的命令:
/goal finish the implementation and make all tests pass
/goal              # 查看当前激活的 goal
/goal clear        # 清除它
每次 Gateway 驱动的 run 结束后,DeerFlow 会用一个 non-thinking 的评估模型,把可见的对话内容拿去和激活的 goal 比对。评估模型必须返回一个带类型的 blocker(missing_evidence、needs_user_input、run_failed、external_wait 或 goal_not_met_yet),并附上可见证据。只有在最近一轮 assistant 回复已被持久化 checkpoint、blocker 是 goal_not_met_yet、评估期间 thread 没有变化、且无进展熔断器没有触发时,DeerFlow 才会注入一次 hidden continuation。安全上限默认是 8 次 hidden continuation;连续两次相同的无进展评估后就会停止。/goal clear 以及任何用户手动输入的新内容,优先级都高于排队中的 continuation。当 goal 被满足时,DeerFlow 会自动清除它,并发布更新后的 thread 状态。
Web UI 会在输入框上方展示当前激活的 goal。同样的命令在 TUI 和受支持的 IM 渠道里也可用。在 Web UI 和受支持的 IM 渠道里,设置 /goal <完成条件> 还会以该条件作为任务启动一次 run;状态查询和清除命令则只管理 goal 状态本身。
手动上下文压缩
在 Web UI 输入框中使用 /compact,可以把当前 thread 的早期上下文压缩成摘要。完整聊天记录仍会保留在界面上,但后续模型调用会基于压缩摘要和最近消息继续。当前历史不足时不会压缩;thread 正在运行任务时会阻止压缩。
Sub-Agents
Sub-agent 是一种执行优化,而不是遇到复杂任务时的默认选择。
lead agent 只会在委派具有明确净收益时动态拉起 sub-agents,例如真正缩短耗时的并行工作、专业能力收益或上下文隔离收益。存在跨 Agent 依赖或重叠副作用的工作不会并行分派;当专业能力或上下文隔离收益明显占优时,一条有界的顺序任务链仍可交给一个 sub-agent 完成。lead agent 会使用能取得收益的最少 sub-agents,并在每一批完成后重新评估,而不会仅仅因为任务规模大或步骤多就继续拆分。每个 sub-agent 都有自己独立的上下文、工具和终止条件,返回结构化结果后由 lead agent 验证并汇总成完整输出。
管理员可以在设置 → 子智能体中添加、修改、停用和删除可复用的工作智能体;内置项和 config.yaml 项会在同一目录中以只读方式展示。默认 Lead Agent 可以使用全部已启用的运行时 sub-agents;页面创建的每个 Custom Agent 则可以选择允许全部、全部禁用或仅允许指定项。该范围同时约束模型可见目录和服务端 task 工具,不能通过直接填写名称绕过。当前版本的设置页管理定义是部署级全局数据,并跟随 agent_storage.backend:单机使用原子文件,多实例使用共享应用数据库。
例如,彼此独立的只读研究可以在并行节省的时间明显高于重复检索和结果合并成本时并发执行;而会修改相同文件、依赖连续测试反馈的仓库重构则由 lead agent 直接完成。当 max_concurrent_subagents 为 1 时,提示词会关闭并行和多批次路由指导,仅在专业能力或上下文隔离具有明确收益时保留委派。
Sandbox 与文件系统
DeerFlow 不只是“会说它能做”,它是真的有一台自己的“电脑”。
每个任务都运行在隔离的 Docker 容器里,里面有完整的文件系统,包括 skills、workspace、uploads、outputs。agent 可以读写和编辑文件,可以执行 bash 命令和代码,也可以查看图片。整个过程都在 sandbox 内完成,可审计、会隔离,不会在不同 session 之间互相污染。
这就是“带工具的聊天机器人”和“真正有执行环境的 agent”之间的差别。
# sandbox 容器内的路径
/mnt/user-data/
├── uploads/          ← 你的文件
├── workspace/        ← agents 的工作目录
└── outputs/          ← 最终交付物
Agentic Browser Control
读取页面和真正“使用”页面不是一回事。除了只读的 web_fetch 和 web_capture 工具外,DeerFlow 还提供一组可选的 agentic browser 工具,为每次对话保持一个实时浏览器会话,让 agent 真正操作页面——导航、读取可交互元素、点击、输入、提交表单,并在重度 JavaScript 站点上完成多步流程。
每次操作都会返回页面可交互元素的最新快照,每个元素用稳定的 [ref] 编号寻址,因此 agent 基于刚观察到的内容行动,而不是猜测选择器。出站 URL 默认会经过 SSRF 筛查。该能力由 Playwright 提供,作为 optional extra 发布,以保持核心安装精简:
cd backend
uv sync --extra browser
uv run playwright install chromium
然后在 config.yaml 中取消注释 group: browser 工具项(browser_navigate、browser_snapshot、browser_click、browser_type、browser_get_text、browser_back、browser_screenshot、browser_close)。make dev / Docker 启动时如果检测到已启用 browser_navigate,会在依赖同步时保留 browser extra。如果配置了 browser control 但缺少 Playwright,Gateway 会启动失败;/api/features 也会在后端无法提供该能力时隐藏 Browser UI。除本地、受信任的调试外,请保持 headless: true 和 allow_private_addresses: false。通过 cdp_url 连接到已有 Chrome 时,DeerFlow 无法强制执行子资源和重定向的 SSRF 防护,因此会 fail closed,除非显式设置 allow_unguarded_cdp: true 确认该风险;仅用于受信任的本地浏览器。Browser session 是进程本地的;启用该工具组时请保持 GATEWAY_WORKERS=1,因为普通 uvicorn worker 调度不提供 thread affinity。
已有的、非 mock 的 Custom Agent 对话会在 browser control 可用、且该 agent 未限制 tool_groups 或已包含 browser 组时,展示同样的 Browser Live 控件。如果显式 allowlist 里没有 browser,这些控件会保持隐藏。
workspace 的 Browser Live 客户端通过二进制 JPEG WebSocket 帧协商画面,每个显示刷新只保留最新的待处理帧,并回收被替换的 object URL。Gateway 控制消息仍是 JSON;未请求二进制能力的客户端继续使用旧的 JSON/base64 帧协议。
Context Engineering
隔离的 Sub-Agent Context:每个 sub-agent 都在自己独立的上下文里运行。它看不到主 agent 的上下文,也看不到其他 sub-agents 的上下文。这样做的目的很直接,就是让它只聚焦当前任务,不被无关信息干扰。
摘要压缩:在单个 session 内,DeerFlow 会比较积极地管理上下文,包括总结已完成的子任务、把中间结果转存到文件系统、压缩暂时不重要的信息。这样在长链路、多步骤任务里,它也能保持聚焦,而不会轻易把上下文窗口打爆。
长期记忆
大多数 agents 会在对话结束后把一切都忘掉,DeerFlow 不一样。
跨 session 使用时,DeerFlow 会逐步积累关于你的持久 memory,包括你的个人偏好、知识背景,以及长期沉淀下来的工作习惯。你用得越多,它越了解你的写作风格、技术栈和重复出现的工作流。memory 保存在本地,控制权也始终在你手里。
默认 DeerMem middleware 模式会先判断候选信息的作用域、持久性和授权属性,再由确定性写入门决定是否保存。只有稳定、描述性的用户级事实能进入长期 memory;当前对话或项目的约束、一次性操作授权仍留在对话状态中。用户全局 summary 必须同时具有用户级作用域和描述性授权属性,基于矛盾的删除也会经过作用域保护;如果删除依赖一条替代事实,只有替代事实真正通过校验并保留下来后才执行删除。这些分类字段只用于本次抽取,不写入 fact 文件,也不增加 LLM 调用次数。memory.mode: tool 的显式 CRUD 仍是独立的模型直写路径。如果通过 memory.backend_config.prompts_dir 覆盖了内置抽取模板,必须同步在自定义模板中加入新的分类字段(memory_update 的 fact/summary/removal 格式与 consolidation 的合并 fact 结构):写入门是 fail closed 的,未迁移的旧模板会导致所有抽取驱动的 fact、summary 与删除写入停止,只能通过 rejected_by_scope_gate 指标和高拒绝率告警发现。
当一个作用域的 fact 达到 max_facts 时,DeerMem 默认仍沿用仅按 confidence 排序的旧策略。可以显式设置 memory.backend_config.fact_eviction_policy: hybrid-v1,改用有界综合分:confidence 65%、用户明确确认的新鲜度 25%、查询召回热度 10%。只有开启 hybrid-v1 或 shadow 模式时才会收集这两类信号元数据。确认由已有的 memory-update LLM 调用返回 factsToReinforce,但只有确定性消息检测也发现用户 reinforcement 信号时才会更新,并同时重置该 fact 的 staleness review 时钟。这个确定性门禁是批次级的:它只能证明当前抽取批次最后六条已过滤消息中的某条用户消息命中了 reinforcement 模式。具体 fact 由 LLM 选择的 factsToReinforce ID 绑定;DeerMem 不会另外校验该信号与 fact 的一一对应关系。重复抽取、自动注入和单纯召回都不会确认 fact。自定义 memory_update prompt 如果希望参与确认新鲜度,需要加入可选的 factsToReinforce 数组。召回热度单独保存在衰减 sidecar 中,只有 memory_search 真正返回的 fact 才增加,不会重写 canonical Markdown 或污染 updatedAt。Hybrid 模式还为 correction 保留有限的最低槽位(容量的 10%,最多 10 个;未使用的槽位会释放给其他类别)。容量删除仍是物理删除,但会留下不含正文的有界审计记录。启用 fact_eviction_shadow_enabled 可以在不改变实际保留结果的情况下比较 hybrid-v1;整个功能不增加 LLM 调用,切回 confidence 即可回滚。
推荐模型
DeerFlow 对模型没有强绑定,只要实现了 OpenAI 兼容 API 的 LLM,理论上都可以接入。不过在下面这些能力上表现更强的模型,通常会更适合 DeerFlow:
- 长上下文窗口(100k+ tokens),适合深度研究和多步骤任务
- 推理能力,适合自适应规划和复杂拆解
- 多模态输入,适合理解图片和视频
- 稳定的 tool use 能力,适合可靠的函数调用和结构化输出
内嵌 Python Client
DeerFlow 也可以作为内嵌的 Python 库使用,不必启动完整的 HTTP 服务。DeerFlowClient 提供了进程内的直接访问方式,覆盖所有 agent 和 Gateway 能力,返回的数据结构与 HTTP Gateway API 保持一致。HTTP Gateway 还提供 DELETE /api/threads/{thread_id},用于在 LangGraph thread 本身被删除之后,清理 DeerFlow 托管的本地 thread 数据:
from deerflow.client import DeerFlowClient

client = DeerFlowClient()

# Chat
response = client.chat("Analyze this paper for me", thread_id="my-thread")

# Streaming(LangGraph SSE 协议:values、messages-tuple、end)
for event in client.stream("hello"):
    if event.type == "messages-tuple" and event.data.get("type") == "ai":
        print(event.data["content"])

# 配置与管理:返回值与 Gateway 对齐的 dict
models = client.list_models()        # {"models": [...]}
skills = client.list_skills()        # {"skills": [...]}
client.update_skill("web-search", enabled=True)
client.upload_files("thread-1", ["./report.pdf"])  # {"success": True, "files": [...]}
client.set_goal("thread-1", "finish the implementation and make all tests pass")
client.get_goal("thread-1")       # {"goal": {...}} or {"goal": None}
client.clear_goal("thread-1")
所有返回 dict 的方法都会在 CI 中通过 Gateway 的 Pydantic 响应模型校验(TestGatewayConformance),以确保内嵌 client 始终和 HTTP API schema 保持同步。完整 API 说明见 backend/packages/harness/deerflow/client.py。
项目 (Projects)
项目把相关会话组织在同一个名称、共享指令和文档架之下。
会话在创建时(选择了某个项目)或之后通过移动菜单加入项目。运行不会修改归属关系:发送消息不会把会话指派或改派到任何项目。把会话移出项目后,它会保持未归属状态,直到再次被显式移动。
移动会话会同时刷新会话顶部的归属信息和项目列表,即使还有较早的元数据请求尚未返回。
项目依赖当前的数据库表和列。如果数据库停留在旧的 0018 rollout 的 0019_thread_incarnations 版本且缺少项目表结构,启动会被拒绝。请先在启动本版本之前按照离线数据库恢复流程处理。
项目依赖当前的数据库表和列。如果数据库停留在旧的 0018 rollout 的 0019_thread_incarnations 版本且缺少项目表结构,启动会被拒绝。请先在启动本版本之前按照离线数据库恢复流程处理。
项目指令 (Project instructions)
每个项目可以保存一段自由文本指令——适用于项目内所有会话的背景、约定和约束——在项目页的 Instructions 标签页编辑,并带有实时字节计数。成员线程每次发起运行时,Gateway 会一次性固定(pin)项目当前状态,把指令渲染成一个有界的、仅在本次请求内有效的 <project> 块:它不会进入系统提示词,也不会写入持久化历史;每次新运行都会读到最新保存的指令。指令长度上限为 projects.instructions_max_bytes(按 UTF-8 字节计,默认 8192,可配范围 256–262144),多字节字符按其 UTF-8 字节长度计数。超限的指令会在写入时被 422 拒绝,绝不会被静默截断。
文档架 (Document shelf)
每个项目都有一个文档架,用于存放整个项目共享的文件,在项目页的 Documents 区域管理:
- 上传文件(按钮或拖拽,每次请求一个文件)。大小限制复用
uploads.max_file_size(默认 50 MiB);重复上传相同内容会返回已有条目,而不是产生重复。 - 列出条目,包含名称、大小、修改时间和来源徽标(直接上传 vs. 从会话保存),并可预览或下载任意条目。
- 从会话文件保存到项目:文档架下方只读的会话文件浏览器按 thread 分组列出成员会话的上传与输出文件,每个条目都带 Save to project 操作。
- 附加到会话(Attach to thread):把文档架文件复制到某个会话的上传目录,走与常规上传相同的接入管线,让该会话可以直接使用。
成员线程的运行还会收到一个按运行渲染的有界 <documents> 索引(由固定快照生成,受 projects.shelf_index_max_entries 和 projects.shelf_index_max_bytes 限制),agent 也可以通过 list_project_documents 和 read_project_document 工具分页浏览文档架并读取文档。
归档读取语义 (Archive read semantics)
归档项目会冻结写入,但保留读取。归档项目中的会话仍可运行,仍会收到项目指令和文档架索引;文档架也保持完全可读:列表、预览/下载、会话文件浏览器和附加到会话都继续可用。上传、保存到项目、把单个文档架文件移入回收站都要求项目处于活跃状态,回收站中的文档也不能恢复到已归档的项目。删除已归档项目仍然允许,并会把它的整个文档架移入回收站。
回收站 (Trash)
删除文档架文档会把它移入回收站而不是直接抹除:条目保留其字节内容和来源项目快照,保留期为 projects.trash_retention_days(默认 30 天),之后保留期清理才可能将其永久清除。/workspace/trash 页面——可从项目页 Documents 区域和侧边栏 Projects 标题进入——列出回收站中的文档及其来源项目和剩余保留天数,提供逐条 Restore(恢复)和 Delete permanently(永久删除)操作,以及清空回收站(Empty trash,立即永久删除回收站中的全部条目,无需等到保留期结束;保留期只决定单条记录在被保留期清理回收前最多能停留多久)。恢复会把文档放回其来源项目;来源项目已删除或已归档时,可以选择一个目标项目;如果目标项目中已有内容完全相同的活跃文件,两个条目会合并。删除项目会在同一步骤中把它的整个文档架移入回收站。
定时任务 (Scheduled Tasks)
DeerFlow 现在在 workspace 里内置了一个一等的定时任务(scheduled-task)MVP。
当前 MVP 能力:
- 在
/workspace/scheduled-tasks管理任务 - 每个定时任务可以选择复用同一个 thread 及其历史对话,也可以选择每次运行新建一个 thread
- 每个任务可以固定使用
lead_agent(默认)或当前用户已有的自定义 agent;未知名字会被拒绝 - 将现有任务复制到创建表单中作为可编辑草稿,不复制运行历史
- 支持
once、cron和interval三种调度方式 - 后台定时执行以非交互式 DeerFlow run 运行(那里不会暴露
ask_clarification) - 当所复用的 thread 或全局执行配额正忙时,到期执行会持久化为
queued,并在可用后启动;队列项在 Gateway 重启后保留,超过scheduler.queue_timeout_seconds后标记为失败 - 当某次执行处于
queued、launching或running时冻结任务定义,避免持久化的执行意外换用新的 prompt、thread 或调度;将任务切换为暂停或删除任务会取消已在等待的执行,而launching/running执行结束后才能重试这些变更;显式手动触发在调度已暂停时仍可等待并执行,且不会自动恢复调度 - 支持暂停、恢复、手动触发、查看历史和删除任务
- 定时任务通过正常的 DeerFlow run 生命周期执行
- 按每页 50 条浏览执行历史;历史页暂停自动刷新,可随时返回最新记录。 仅在读取成功后显示条数,加载中或失败不会误显示为零条。
通过 API 筛选执行历史
排查失败记录时,无需先下载所有成功记录。已认证且具有 threads:read 权限的客户端,可以针对自己的任务请求 GET /api/scheduled-tasks/{task_id}/runs?status=failed&limit=50&offset=0。可选的 status 支持 queued、launching、running、success、failed、skipped、interrupted;这些是执行记录的状态,completed 等任务状态会被拒绝(422)。
筛选先于分页执行。limit(1–200,默认 50)和 offset(非负整数,默认 0)作用于匹配记录,按创建时间、ID 依次降序排列。不传 status 时保留原有的混合历史数组,无匹配项返回 []。此 API 不改变任务执行行为,workspace 历史界面仍展示未筛选的记录。
当前 MVP 限制:
- 暂时还没有可在对话中创建任务的
schedule_task工具 - 没有纯文本通知任务
- 没有渠道或 GitHub 分发目标
通过 config.yaml -> scheduler.enabled 开启后台轮询。手动触发使用同样的 scheduled-task 资源和执行路径。
定时任务运行会读取 config.yaml 中的 scheduler.recursion_limit(默认 1000,与 Web UI 的交互式预算一致)。超过 max_recursion_limit 的值会被截断。该字段在 dispatch 时读取,因此下一次定时运行即可生效,无需重启 Gateway。
后台调度器默认是单实例。多 Pod 部署时,请设置 scheduler.multi_instance: true,并使用共享 Postgres、run_ownership.heartbeat_enabled: true 和 run_events.backend: db;启动和周期性恢复会保留仍由对端持有的运行,把过期的 launch claim 原子退回队列,只接管过期的 run lease,并隔离过期的 launch 写入。max_concurrent_runs 是跨 Pod 共享的全局上限,只计入 launching / running 的执行;等待中的 queued 行不占用该配额。没有这些配置时,请只在一个 Gateway Pod 上启用调度器。这些 scheduler 字段只在启动时生效;修改后需要一起重启所有 Gateway Pod。
通过 API 预览 cron 执行时间
已认证且具有 threads:read 权限的客户端,可在创建任务前调用 POST /api/scheduled-tasks/preview-cron:
{"cron":"0 9 * * 1-5","timezone":"Asia/Shanghai","count":3,"start_at":"2026-09-12T00:00:00Z"}
响应包含规范化的 cron、timezone、生效的 UTC start_at,以及 occurrences 列表中的 UTC run_at 和带偏移量的 local_time。此例的首次执行时间为 2026-09-14T01:00:00Z / 2026-09-14T09:00:00+08:00。
count 为 1–10 的整数,默认 5。start_at 必须带时区,省略时只读取一次服务器当前时间。cron 沿用调度器的五字段语法,最长 256 字符;时区名称最长 128 字符。输入无效或无法计算所需未来时间时返回 422。预览沿用实际调度器的夏令时语义,不创建任务、thread 或 run,也不预留执行资源。此能力目前通过 API 提供,workspace 表单尚未展示这些时间。
升级说明
- 升级
GATEWAY_WORKERS > 1且scheduler.enabled: true的部署前,要么只在一个 Gateway worker 上启用调度器,要么配置scheduler.multi_instance: true,并同时使用共享 Postgres、run_ownership.heartbeat_enabled: true和run_events.backend: db。升级后的 Gateway 会在启动时拒绝这种不安全组合,而不是静默启动。 - 多实例模式下,
scheduler.max_concurrent_runs是集群级执行上限,而不是每个 Pod 各自一份。它计入launching和running的定时执行,因此容量不会随副本数倍增;持久化等待行仍在上限之外。 scheduler.multi_instance以及相关的 scheduler、ownership、run-event 设置都只在启动时生效。变更需要协调重启所有 Gateway Pod;只改 ConfigMap 不会启用多实例恢复。
终端工作台 (TUI)
deerflow 是一个面向终端用户的工作台,内嵌运行在 DeerFlowClient 之上——无需启动 Gateway、前端、nginx 或 Docker,同时沿用与 DeerFlow 其它部分相同的 config.yaml、checkpointer、技能、记忆、MCP 和沙箱配置。
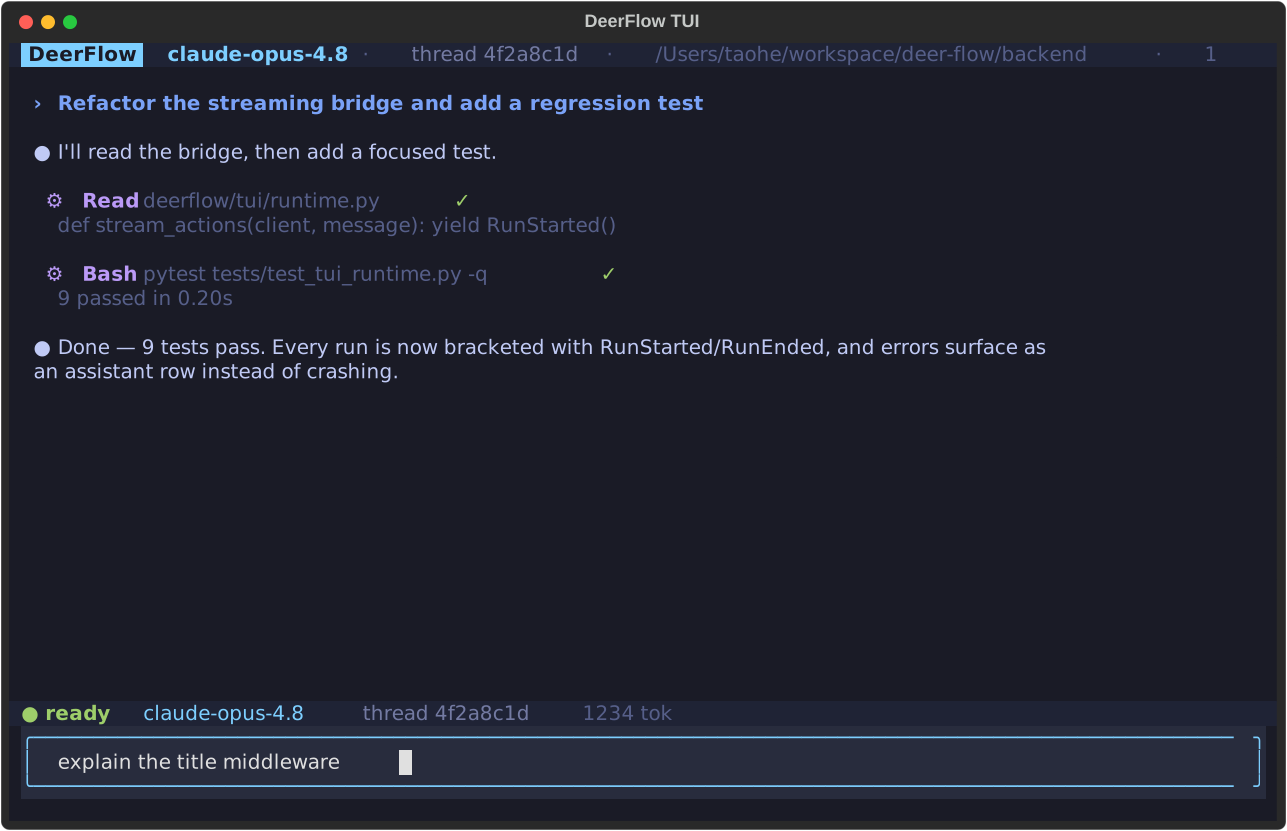
uv pip install 'deerflow-harness[tui]'        # 可选的 'textual' 依赖

deerflow                                      # 启动终端 UI(需要 TTY)
deerflow --continue                           # 恢复最近一次会话
deerflow --resume THREAD                      # 按 id 恢复指定会话
deerflow --print "总结一下这个仓库"             # 无头模式,结果打印到 stdout
deerflow --json  "hello"                       # 无头模式,输出按行分隔的 StreamEvent
键盘驱动的对话界面:流式渲染的对话区(回答按 Markdown 渲染)、紧凑的工具活动卡片、/ 斜杠命令面板、/model 与 /threads 选择器、输入历史,以及 Esc / Ctrl+C 打断。在 TUI 里开启的会话也会出现在 Web UI 侧边栏——它会以本地默认用户身份写入共享的会话存储,因此终端与网页保持同步,无需运行 Gateway。
完整说明见 backend/docs/TUI.md。
文档
⚠️ 安全使用
不恰当的部署可能导致安全风险
DeerFlow 具备系统指令执行、资源操作、业务逻辑调用等关键高权限能力,默认设计为部署在本地可信环境(仅本机 127.0.0.1 回环访问)。若您将 agent 部署至不可信局域网、公网云服务器等可被多终端访问的网络环境,且未采取严格的安全防护措施,可能导致安全风险,例如:
- 未授权的非法调用:agent 功能被未授权的第三方、公网恶意扫描程序探测到,进而发起批量非法调用请求,执行系统命令、文件读写等高危操作,可能导致安全后果。
- 合规与法律风险:若 agent 被非法调用用于实施网络攻击、信息窃取等违法违规行为,可能产生法律责任与合规风险。
Gateway 管理员权限等同于代码执行
管理员可以注册 stdio 类型的 MCP server,其命令会在 Gateway 容器内执行。API 会把可执行命令限制在一个允许清单内(默认为 npx、uvx,可通过 DEER_FLOW_MCP_STDIO_COMMAND_ALLOWLIST 扩展),并拒绝会导致任意代码求值的参数与环境变量。这属于纵深防御,而不是安全边界:这类启动器本身的用途就是拉取并运行远程包,因此请将 Gateway 管理员权限视为等同于在宿主机上执行代码,并据此谨慎授权。
部署默认值
Docker 部署栈默认只把入口端口发布在 127.0.0.1 上,与上文所述的本地可信环境模型一致。若需要从其他机器访问,请在 .env 中设置 BIND_HOST(例如 BIND_HOST=0.0.0.0),并且必须在落实下方的安全措施之后再这样做。
请在主机变为可访问之前完成首次初始化设置。 全新实例尚未创建任何账号,因此对于任何非仅回环访问的部署,请在启动后立即通过 /setup 创建管理员账号。
安全使用建议
注意:建议您将 DeerFlow 部署在本地可信的网络环境下。 若您有跨设备、跨网络的部署需求,必须加入严格的安全措施。例如,采取如下手段:
- 设置访问 IP 白名单:使用
iptables,或部署硬件防火墙 / 带访问控制(ACL)功能的交换机等,配置规则设置 IP 白名单,拒绝其他所有 IP 进行访问。 - 前置身份验证:配置反向代理(nginx 等),并开启高强度的前置身份验证功能,禁止无任何身份验证的访问。
- 网络隔离:若有可能,建议将 agent 和可信设备划分到同一个专用 VLAN,与其他网络设备做隔离。
- 持续关注项目更新:请持续关注 DeerFlow 项目的安全功能更新。
参与贡献
欢迎参与贡献。开发环境、工作流和相关规范见 CONTRIBUTING.md。
目前回归测试已经覆盖 Docker sandbox 模式识别,以及 backend/tests/ 中 provisioner kubeconfig-path 处理相关测试。
许可证
本项目采用 MIT License 开源发布。
致谢
DeerFlow 建立在开源社区大量优秀工作的基础上。所有让 DeerFlow 成为可能的项目和贡献者,我们都心怀感谢。毫不夸张地说,我们是站在巨人的肩膀上继续往前走。
特别感谢以下项目带来的关键支持:
- LangChain:它们提供的优秀框架支撑了我们的 LLM 交互与 chains,让整体集成和能力编排顺畅可用。
- LangGraph:它们在多 agent 编排上的创新方式,是 DeerFlow 复杂工作流得以成立的重要基础。
这些项目体现了开源协作真正的力量,我们也很高兴能继续建立在这些基础之上。
核心贡献者
感谢 DeerFlow 的核心作者,是他们的判断、投入和持续推进,才让这个项目真正落地: